XiangShan
RISC-V生态系统XiangShan 是一个用 Chisel 编写的高性能乱序 RV64 核心,于 2019 年在中国科学院计算技术研究所启动。它的各代产品以湖泊命名,从 2021 年流片的雁栖湖,到南湖和昆明湖。
概述
| 规格 | 值 |
|---|---|
| ISA 支持 | Yanqihu:RV64GC,Nanhu:RV64GCBK |
| 微架构 | 乱序、多发射;世代为 Yanqihu、Nanhu 和 Kunminghu |
| 性能密度 | 1.3 GHz 下 5.3 CoreMark/MHz(Yanqihu) |
| 资源占用 | 面向 ASIC;项目未公布 FPGA LUT 数量 |
| 时钟域 | 28 nm 下 1.3 GHz(Yanqihu),14 nm 下 2 GHz(Nanhu,2023 年流片) |
XiangShan 是一款开源的高性能 RISC-V 处理器,实现了 64 位指令集架构。其核心采用乱序执行,允许指令以不同于原始程序顺序的顺序进行处理。这种方法使处理器能够在其他指令等待依赖关系解决的同时执行独立操作,从而利用指令级并行性。硬件使用 Chisel 描述,这是一种构建在 Scala 之上的硬件构建语言,并在 Mulan Permissive Software License, Version 2 下分发。
这个名字是中文“香山”的意思,香山是北京西部的一座公园,而每一代设计都以湖泊命名。第一代 Yanqihu 于 2021 年以 28 纳米工艺流片,运行频率为 1.3 GHz,达到 5.3 CoreMark/MHz。流片意味着将完成的设计送往工厂进行制造。Nanhu 是第二代,于 2023 年以 14 nm 工艺、2 GHz 频率、RV64GCBK 流片。第三代 Kunminghu 正在积极开发中。
微架构

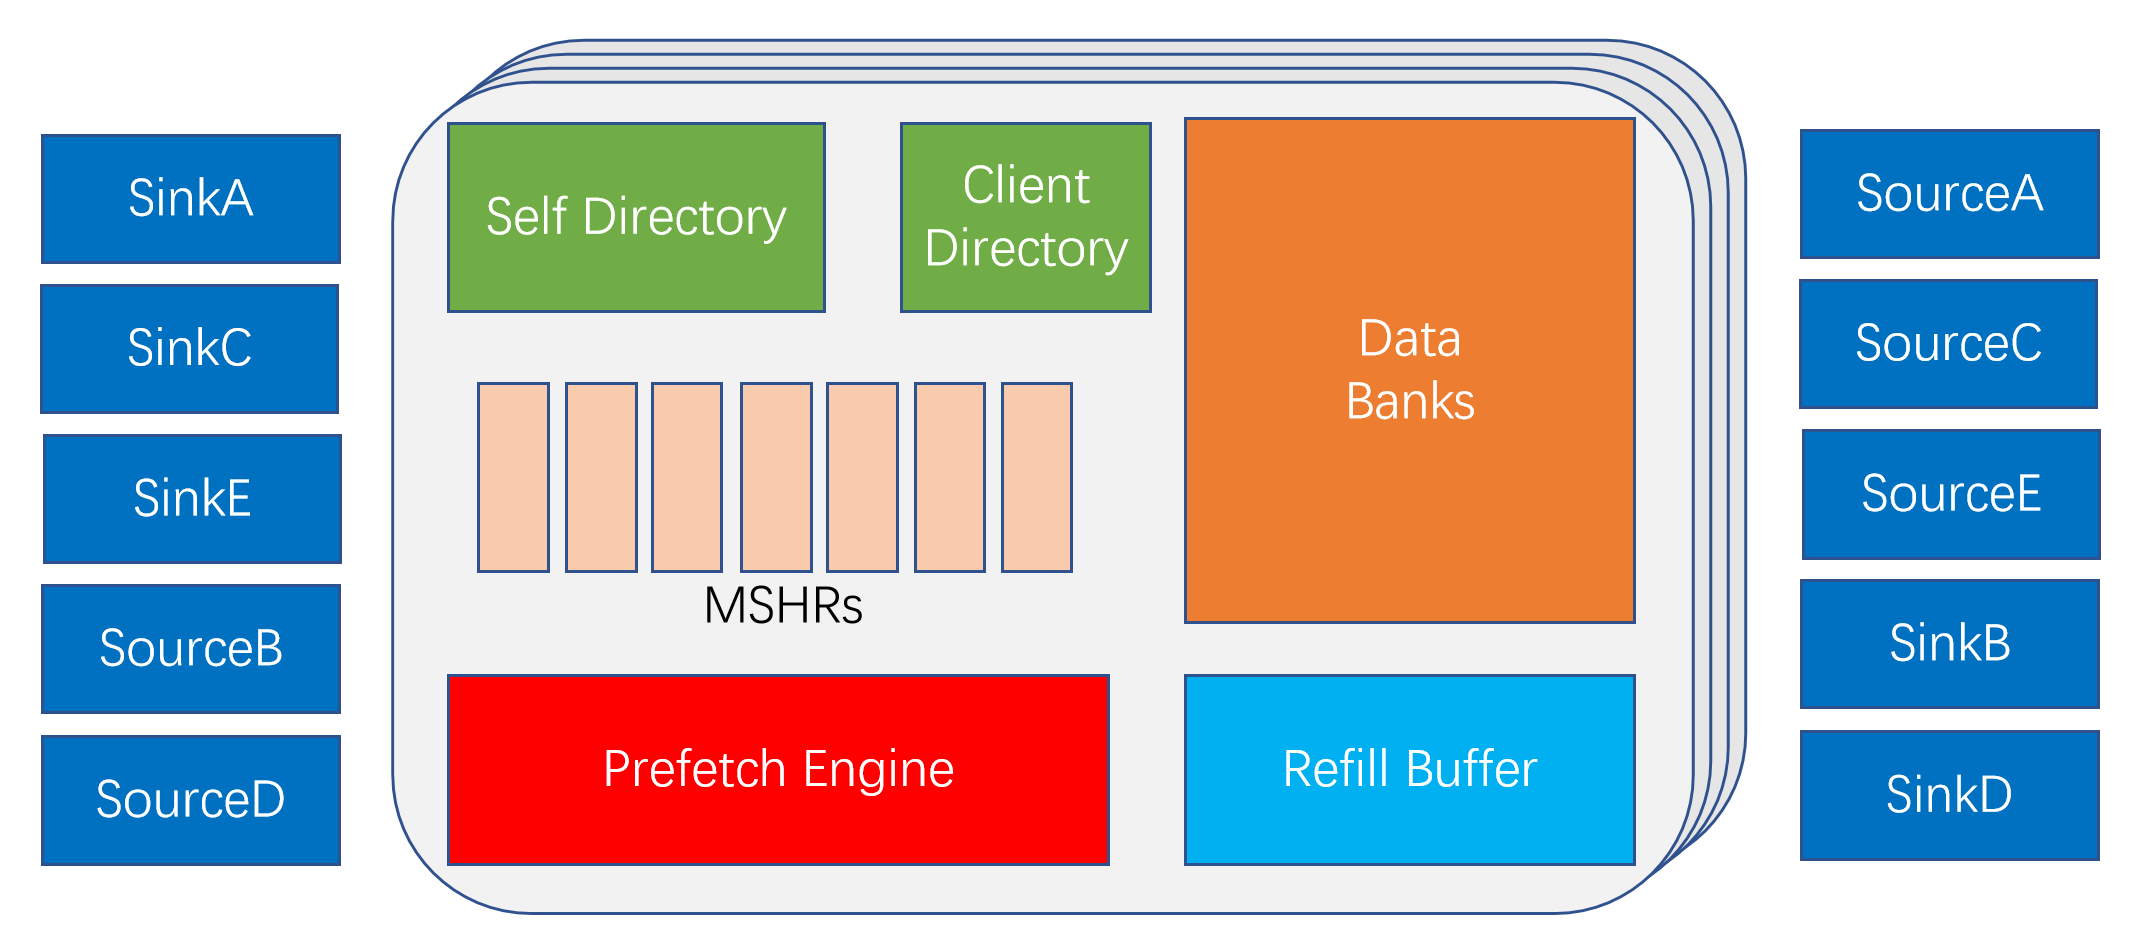
XiangShan 采用乱序、多发射架构,允许多条指令同时分派和执行,同时保持程序可见的正确执行顺序。在 Nanhu 代中,内存子系统包括两条加载流水线、两条存储地址流水线和两条存储数据流水线。其数据缓存每周期支持两次 64 位读取操作,为内存密集型工作负载提供额外带宽。在各个核心之上,Huancun 提供共享末级缓存,允许多个核心访问公共缓存层次结构。
虚拟内存访问通过 Translation Lookaside Buffer(TLB)进行转换,额外的 L2 TLB 提供进一步的转换容量。物理内存访问权限和属性通过 Physical Memory Protection(PMP)和 Physical Memory Attributes(PMA)机制进行检查。处理器核心与周围系统之间的通信通过 TileLink 互连协议处理。
| 部分 | 雁栖湖 | 南湖 |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| 执行 | 乱序、多发射 | 乱序、多发射 |
| 加载流水线 | 两条 | 两条 |
| 存储流水线 | 两个地址、两个数据 | 两个地址、两个数据 |
| L1 数据缓存 | 两个 64 位读端口,一个行宽写端口 | 两个 64 位读端口,一个行宽写端口 |
| 末级缓存 | Huancun,共享 | Huancun,共享 |
| 互连 | TileLink | TileLink |
内存与寄存器映射
XiangShan 的默认物理地址映射为系统组件分配特定地址范围,包括主内存、外设设备和保留区域。Physical Memory Attributes(PMA)配置定义了这些区域允许的访问属性,确定每个地址范围可以执行哪些类型的操作。当软件尝试访问定义区域之外的地址或执行相应属性禁止的操作时,处理器会引发访问故障。此机制允许硬件强制执行平台的物理内存布局和访问限制。
| 地区 | 地址范围 |
|---|---|
| 外设空间 | 0x0000_0000 到 0x7fff_ffff |
| DDR | 0x8000_0000 到 0xf_ffff_ffff |
| CLINT | 0x3800_0000 到 0x3800_ffff |
| 总线错误单元 | 0x3801_0000 到 0x3801_ffff |
| 调试模块 | 0x3802_0000 到 0x3802_0fff |
| L3 缓存控制 | 0x3900_0000 到 0x3900_0fff |
| PLIC | 0x3c00_0000 到 0x3fff_ffff |
平台级中断控制器(PLIC)通过源 1-64 接收外部中断请求。源 65 和 66 分别保留给核心 0 和核心 1 产生的总线错误中断。
物理实现
XiangShan 已从原型设计推进到物理硅实现。其第一代设计 Yanqihu 于 2021 年使用 28 nm 制造工艺完成流片,报告的工作频率为 1.3 GHz,达到 5.3 CoreMark/MHz。第二代 Nanhu 于 2023 年以 14 nm 工艺、2 GHz 流片。后续几代追求更先进的半导体工艺节点和更高的工作频率,反映了该项目朝着能力越来越强的处理器实现持续发展。
| 代 | 报告数值 |
|---|---|
| Yanqihu | 28 nm,1.3 GHz,5.3 CoreMark/MHz,2021 年流片 |
| Nanhu | 14 nm,2 GHz,2023 年流片 |
| Kunminghu | 撰写时仍在开发中 |
| FPGA | 核心未公布 LUT 数量 |
识别部件
XiangShan 是一款开源处理器设计,可以集成到不同的 SoC 实现中。识别基于 XiangShan 的系统需要检查硬件平台,而不是依赖通用处理器标识符。首先从板卡文档、SoC 规格或芯片标记入手,以识别底层实现。如果系统可访问,请检查其启动日志、设备树和硬件描述以获取处理器信息,包括 ISA、核心数、缓存配置和供应商特定标识符。如果平台为这些 CSR 暴露有意义的值,则报告的 mvendorid、marchid 和 mimpid CSR 也可以帮助识别实现。
内存映射将调试模块和缓存控制器放置在固定地址,这些地址可识别平台。
| 出现位置 | 确认方法 |
|---|---|
| Yanqihu 和 Nanhu 板 | 平台文档与固定外设映射 |
| 研究系统 | 项目论文和发布说明 |
| 软件镜像 | 设备树与调试模块基地址 |
反汇编与调试
调试模块遵循 RISC-V External Debug Support 0.13.2,位于外设空间中的固定地址。OpenOCD 默认通过远程 bitbang 连接与其连接。
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| 项目 | 值 |
|---|---|
| ISA | Yanqihu:RV64GC,Nanhu:RV64GCBK |
| 编译器标志 | Yanqihu 使用 -march=rv64gc -mabi=lp64d;Nanhu 使用 -march=rv64gcbk -mabi=lp64d,并添加构建所启用的扩展 |
| 调试模块 | 0x3802_0000 到 0x3802_0fff,协议 0.13.2 |
| 程序缓冲区 | 16 字节,抽象命令使用它 |
| 触发器 | 10 个匹配控制触发器 |
| misa (0x301) | ISA 与已启用的扩展 |
| mvendorid (0xF11) | JEDEC 供应商 ID,只读 |
| marchid (0xF12) | 微架构 ID,只读 |
| mimpid (0xF13) | 实现版本,只读 |
| mhartid (0xF14) | 运行代码的 hart,只读 |
历史
中国科学院计算技术研究所于 2019 年启动 XiangShan,第一代的工作于 2020 年 6 月开始。Peng Cheng Laboratory 完成了大部分物理设计,这一步骤将逻辑转化为工厂可以生产的布局。
团队在 MICRO 2022 这一主要计算机体系结构会议上展示了其开发方法。与行业合作伙伴共同创立的非营利组织 Beijing Institute of Open Source Chip 现在协调开发。
使用场景
XiangShan 的目标是达到商用应用处理器的性能,即手机和服务器中的那种处理器。研究人员使用它来研究高端处理器设计,该项目与核心一起发布其仿真、验证和性能分析工具。