XiangShan
RISC-V-ÖkosystemXiangShan ist ein leistungsstarker Out-of-Order-RV64-Kern, geschrieben in Chisel, gestartet 2019 am Institut für Computertechnologie der Chinesischen Akademie der Wissenschaften. Seine Generationen tragen Seenamen, von Yanqihu, 2021 als Tape-out gefertigt, bis Nanhu und Kunminghu.
Überblick
| Spezifikation | Wert |
|---|---|
| ISA-Unterstützung | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Mikroarchitektur | Out-of-Order, Multi-Issue; die Generationen sind Yanqihu, Nanhu und Kunminghu |
| Leistungsdichte | 5,3 CoreMark/MHz bei 1,3 GHz (Yanqihu) |
| Ressourcenbedarf | ASIC-orientiert; das Projekt veröffentlicht keine FPGA-LUT-Anzahl |
| Taktbereich | 1,3 GHz auf 28 nm (Yanqihu), 2 GHz auf 14 nm (Nanhu, Tape-out 2023) |
XiangShan ist ein quelloffener Hochleistungs-RISC-V-Prozessor, der die 64-Bit-Befehlssatzarchitektur implementiert. Seine Kerne verwenden Out-of-Order-Ausführung, wodurch Befehle in einer anderen Reihenfolge als ihrer ursprünglichen Programmsequenz verarbeitet werden können. Dieser Ansatz ermöglicht es dem Prozessor, Befehlsebenen-Parallelität zu nutzen, indem unabhängige Operationen ausgeführt werden, während andere Befehle auf die Auflösung ihrer Abhängigkeiten warten. Die Hardware ist in Chisel beschrieben, einer auf Scala aufbauenden Hardware-Konstruktionssprache, und wird unter der Mulan Permissive Software License, Version 2, vertrieben.
Der Name ist das chinesische Wort für die Duftenden Hügel, einen Park im Westen Pekings, und jede Design-Generation trägt den Namen eines Sees. Die erste Generation, Yanqihu, wurde 2021 in einem 28-Nanometer-Prozess tape-out-gefertigt und lief mit 1,3 GHz bei 5,3 CoreMark/MHz. Tape-out bedeutet, ein fertiges Design zur Fertigung an eine Fabrik zu schicken. Nanhu ist die zweite Generation, 2023 in 14 nm bei 2 GHz mit RV64GCBK tape-out-gefertigt. Kunminghu, die dritte, befindet sich in aktiver Entwicklung.
Mikroarchitektur

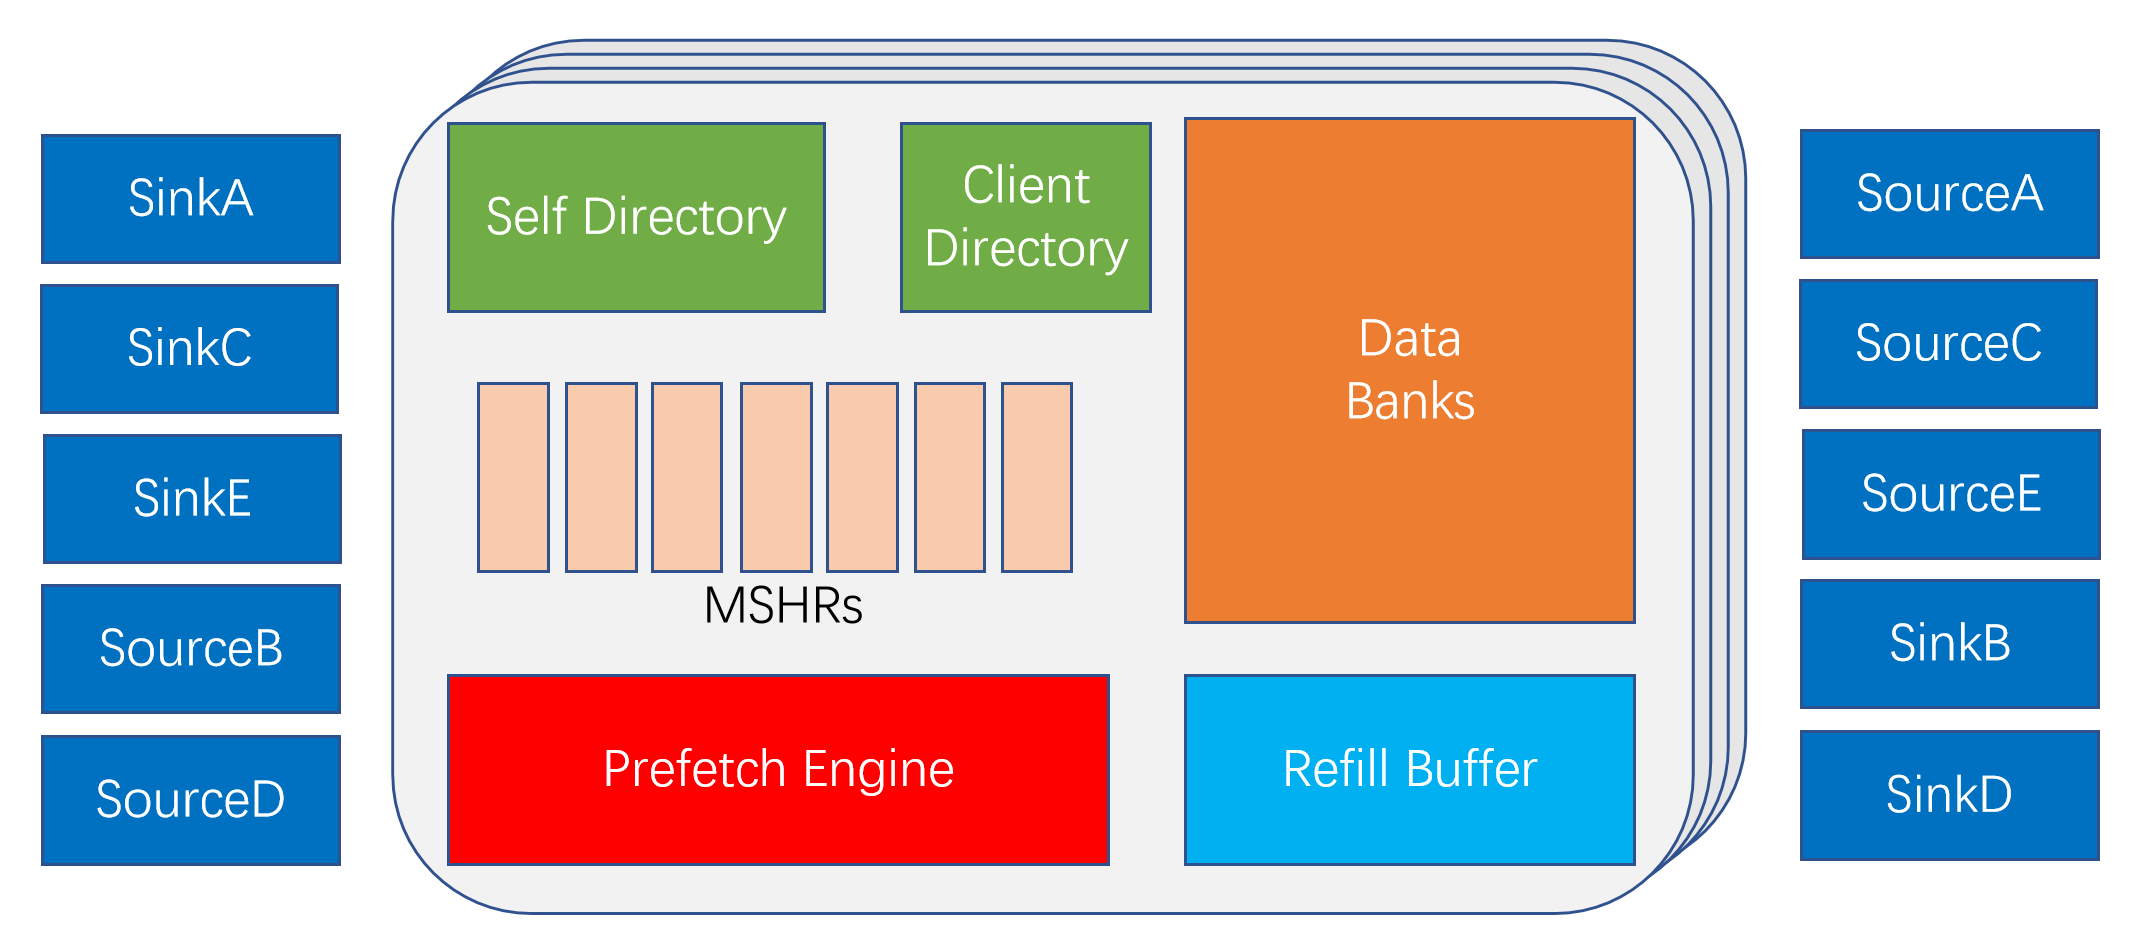
XiangShan verwendet eine Out-of-Order-Architektur mit Mehrfachausgabe, die es ermöglicht, mehrere Befehle gleichzeitig zu verteilen und auszuführen, während die korrekte, für das Programm sichtbare Ausführungsreihenfolge erhalten bleibt. In der Nanhu-Generation umfasst das Speichersubsystem zwei Ladepipelines, zwei Speicheradresspipelines und zwei Speicherdatenpipelines. Sein Datencache unterstützt zwei 64-Bit-Leseoperationen pro Zyklus und bietet zusätzliche Bandbreite für speicherintensive Arbeitslasten. Oberhalb der einzelnen Kerne stellt Huancun einen gemeinsam genutzten Last-Level-Cache bereit, der es mehreren Kernen ermöglicht, auf eine gemeinsame Cache-Hierarchie zuzugreifen.
Zugriffe auf den virtuellen Speicher werden über einen Translation Lookaside Buffer (TLB) übersetzt, wobei ein zusätzlicher L2-TLB weitere Übersetzungskapazität bereitstellt. Berechtigungen und Attribute für den Zugriff auf den physischen Speicher werden über die Mechanismen Physical Memory Protection (PMP) und Physical Memory Attributes (PMA) geprüft. Die Kommunikation zwischen den Prozessorkernen und dem umgebenden System erfolgt über das TileLink-Verbindungsprotokoll.
| Teil | Yanqihu | Nanhu |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| Ausführung | Out of order, Multi-Issue | Out of order, Multi-Issue |
| Load-Pipelines | Zwei | Zwei |
| Store-Pipelines | Zwei Adress-, zwei Datenpfade | Zwei Adress-, zwei Datenpfade |
| L1-Datencache | Zwei 64-Bit-Leseports, ein Schreibport in Zeilenbreite | Zwei 64-Bit-Leseports, ein Schreibport in Zeilenbreite |
| Last-Level-Cache | Huancun, gemeinsam genutzt | Huancun, gemeinsam genutzt |
| Verbindung | TileLink | TileLink |
Speicher- und Registerkarte
Die standardmäßige physische Adresskarte von XiangShan weist Systemkomponenten bestimmte Adressbereiche zu, darunter Hauptspeicher, Peripheriegeräte und reservierte Bereiche. Die Konfiguration Physical Memory Attributes (PMA) definiert die zulässigen Zugriffseigenschaften für diese Bereiche und bestimmt, welche Arten von Operationen in jedem Adressbereich ausgeführt werden dürfen. Wenn Software versucht, auf eine Adresse außerhalb der definierten Bereiche zuzugreifen oder eine durch die entsprechenden Attribute verbotene Operation auszuführen, löst der Prozessor einen Zugriffsfehler aus. Dieser Mechanismus ermöglicht es der Hardware, das physische Speicherlayout und die Zugriffsbeschränkungen der Plattform durchzusetzen.
| Region | Adressbereich |
|---|---|
| Peripherieraum | 0x0000_0000 bis 0x7fff_ffff |
| DDR | 0x8000_0000 bis 0xf_ffff_ffff |
| CLINT | 0x3800_0000 bis 0x3800_ffff |
| Bus-Fehler-Einheit | 0x3801_0000 bis 0x3801_ffff |
| Debug-Modul | 0x3802_0000 bis 0x3802_0fff |
| L3-Cache-Steuerung | 0x3900_0000 bis 0x3900_0fff |
| PLIC | 0x3c00_0000 bis 0x3fff_ffff |
Der Platform-Level Interrupt Controller (PLIC) empfängt externe Interrupt-Anforderungen über die Quellen 1 bis 64. Die Quellen 65 und 66 sind für Busfehler-Interrupts reserviert, die von Kern 0 bzw. Kern 1 erzeugt werden.
Physische Implementierung
XiangShan hat den Prototypenstatus hinter sich gelassen und ist in der physischen Silizium-Implementierung angekommen. Das Design der ersten Generation, Yanqihu, schloss 2021 den Tape-out in einem 28-nm-Fertigungsprozess ab, mit einer angegebenen Betriebsfrequenz von 1,3 GHz und 5,3 CoreMark/MHz. Die zweite Generation, Nanhu, wurde 2023 in einem 14-nm-Prozess bei 2 GHz tape-out-gefertigt. Nachfolgende Generationen strebten fortschrittlichere Halbleiter-Prozessknoten und höhere Betriebsfrequenzen an, was die fortgesetzte Entwicklung des Projekts hin zu immer leistungsfähigeren Prozessor-Implementierungen widerspiegelt.
| Generation | Gemeldete Zahl |
|---|---|
| Yanqihu | 28 nm, 1.3 GHz, 5.3 CoreMark/MHz, in 2021 fertiggestellt |
| Nanhu | 14 nm, 2 GHz, fertiggestellt in 2023 |
| Kunminghu | Zum Zeitpunkt der Erstellung in Entwicklung |
| FPGA | Keine LUT-Anzahl für den Kern veröffentlicht |
Identifizierung des Bauteils
XiangShan ist ein quelloffenes Prozessordesign, das in verschiedene SoC-Implementierungen integriert werden kann. Um ein System auf Basis von XiangShan zu identifizieren, muss die Hardwareplattform untersucht werden, anstatt sich auf eine generische Prozessorkennung zu verlassen. Beginnen Sie mit der Board-Dokumentation, den SoC-Spezifikationen oder den Chip-Markierungen, um die zugrunde liegende Implementierung zu identifizieren. Wenn das System zugänglich ist, prüfen Sie seine Boot-Protokolle, den Device Tree und die Hardwarebeschreibung auf Prozessorinformationen, einschließlich ISA, Kernanzahl, Cache-Konfiguration und herstellerspezifischen Kennungen. Die gemeldeten CSRs mvendorid, marchid und mimpid können ebenfalls zur Identifizierung der Implementierung beitragen, sofern die Plattform aussagekräftige Werte dafür bereitstellt.
Die Speicherkarte platziert das Debug-Modul und die Cache-Controller an festen Adressen, wodurch die Plattform identifiziert wird.
| Wo es erscheint | So bestätigen Sie es |
|---|---|
| Yanqihu- und Nanhu-Boards | Plattformdokumentation und feste Peripheriezuordnung |
| Forschungssysteme | Projektpapiere und Versionshinweise |
| Software-Images | Device Tree und Basisadresse des Debug-Moduls |
Disassemblierung und Debugging
Das Debug-Modul folgt RISC-V External Debug Support 0.13.2 und befindet sich an einer festen Adresse im Peripheriebereich. OpenOCD verbindet sich standardmäßig über eine Remote-Bitbang-Verbindung damit.
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| Element | Wert |
|---|---|
| ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Compiler-Flags | -march=rv64gc -mabi=lp64d für Yanqihu; -march=rv64gcbk -mabi=lp64d für Nanhu, füge die vom Build aktivierten Erweiterungen hinzu |
| Debug-Modul | 0x3802_0000 bis 0x3802_0fff, Protokoll 0.13.2 |
| Programmpuffer | 16 Bytes, abstrakte Befehle verwenden ihn |
| Trigger | 10 Match-Control-Trigger |
| misa (0x301) | ISA und aktivierte Erweiterungen |
| mvendorid (0xF11) | JEDEC-Anbieter-ID, schreibgeschützt |
| marchid (0xF12) | Mikroarchitektur-ID, schreibgeschützt |
| mimpid (0xF13) | Implementierungsversion, schreibgeschützt |
| mhartid (0xF14) | Hart, der den Code ausführt, schreibgeschützt |
Geschichte
Das Institut für Computertechnologie der Chinesischen Akademie der Wissenschaften startete XiangShan im Jahr 2019, und die Arbeit an der ersten Generation begann im Juni 2020. Das Peng Cheng Laboratory führte einen Großteil des physischen Designs durch, also den Schritt, der die Logik in ein Layout umwandelt, das eine Fabrik produzieren kann.
Das Team stellte seine Entwicklungsmethoden auf der MICRO 2022 vor, einer bedeutenden Konferenz für Computerarchitektur. Das Beijing Institute of Open Source Chip, eine mit Industriepartnern gegründete gemeinnützige Organisation, koordiniert heute die Entwicklung.
Wo er verwendet wird
XiangShan zielt auf die Leistung kommerzieller Anwendungsprozessoren ab, wie sie in Telefonen und Servern zu finden sind. Forscher nutzen es, um das Design von High-End-Prozessoren zu untersuchen, und das Projekt veröffentlicht seine Simulations-, Verifikations- und Leistungsanalysewerkzeuge zusammen mit dem Kern.