XiangShan
RISC-V 생태계XiangShan은 2019년 중국과학원 컴퓨팅기술연구소에서 시작된, Chisel로 작성된 고성능 비순차 실행 RV64 코어입니다. 각 세대는 2021년 테이프아웃된 옌치후(雁栖湖)부터 난후(南湖), 쿤밍후(昆明湖)에 이르기까지 호수 이름을 따릅니다.
개요
| 사양 | 값 |
|---|---|
| ISA 지원 | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| 마이크로아키텍처 | 비순차 실행, 다중 발행. 세대는 Yanqihu, Nanhu, Kunminghu |
| 성능 밀도 | 1.3 GHz에서 5.3 CoreMark/MHz (Yanqihu) |
| 리소스 풋프린트 | ASIC 지향. 프로젝트는 FPGA LUT 수를 공개하지 않음 |
| 클록 도메인 | 28 nm에서 1.3 GHz (Yanqihu), 14 nm에서 2 GHz (Nanhu, 2023년 테이프아웃) |
XiangShan은 64비트 명령어 집합 아키텍처를 구현한 오픈 소스 고성능 RISC-V 프로세서입니다. 이 코어는 비순차 실행을 채택하여 명령어를 원래 프로그램 순서와 다른 순서로 처리할 수 있습니다. 이 접근 방식은 다른 명령어가 종속성 해결을 기다리는 동안 독립적인 연산을 실행함으로써 프로세서가 명령어 수준 병렬성을 활용할 수 있게 합니다. 하드웨어는 Scala 위에 구축된 하드웨어 구축 언어인 Chisel로 기술되며, Mulan Permissive Software License, Version 2에 따라 배포됩니다.
이 이름은 베이징 서부의 공원인 향산을 뜻하는 중국어이며, 각 세대의 설계는 호수의 이름을 따릅니다. 첫 세대인 Yanqihu는 2021년에 28나노미터 공정으로 테이프아웃되었고 1.3 GHz로 동작하여 5.3 CoreMark/MHz를 달성했습니다. 테이프아웃은 완성된 설계를 제조를 위해 공장으로 보내는 것을 의미합니다. Nanhu는 두 번째 세대로, 2023년에 14 nm에서 2 GHz로 RV64GCBK와 함께 테이프아웃되었습니다. 세 번째인 Kunminghu는 현재 활발히 개발 중입니다.
마이크로아키텍처

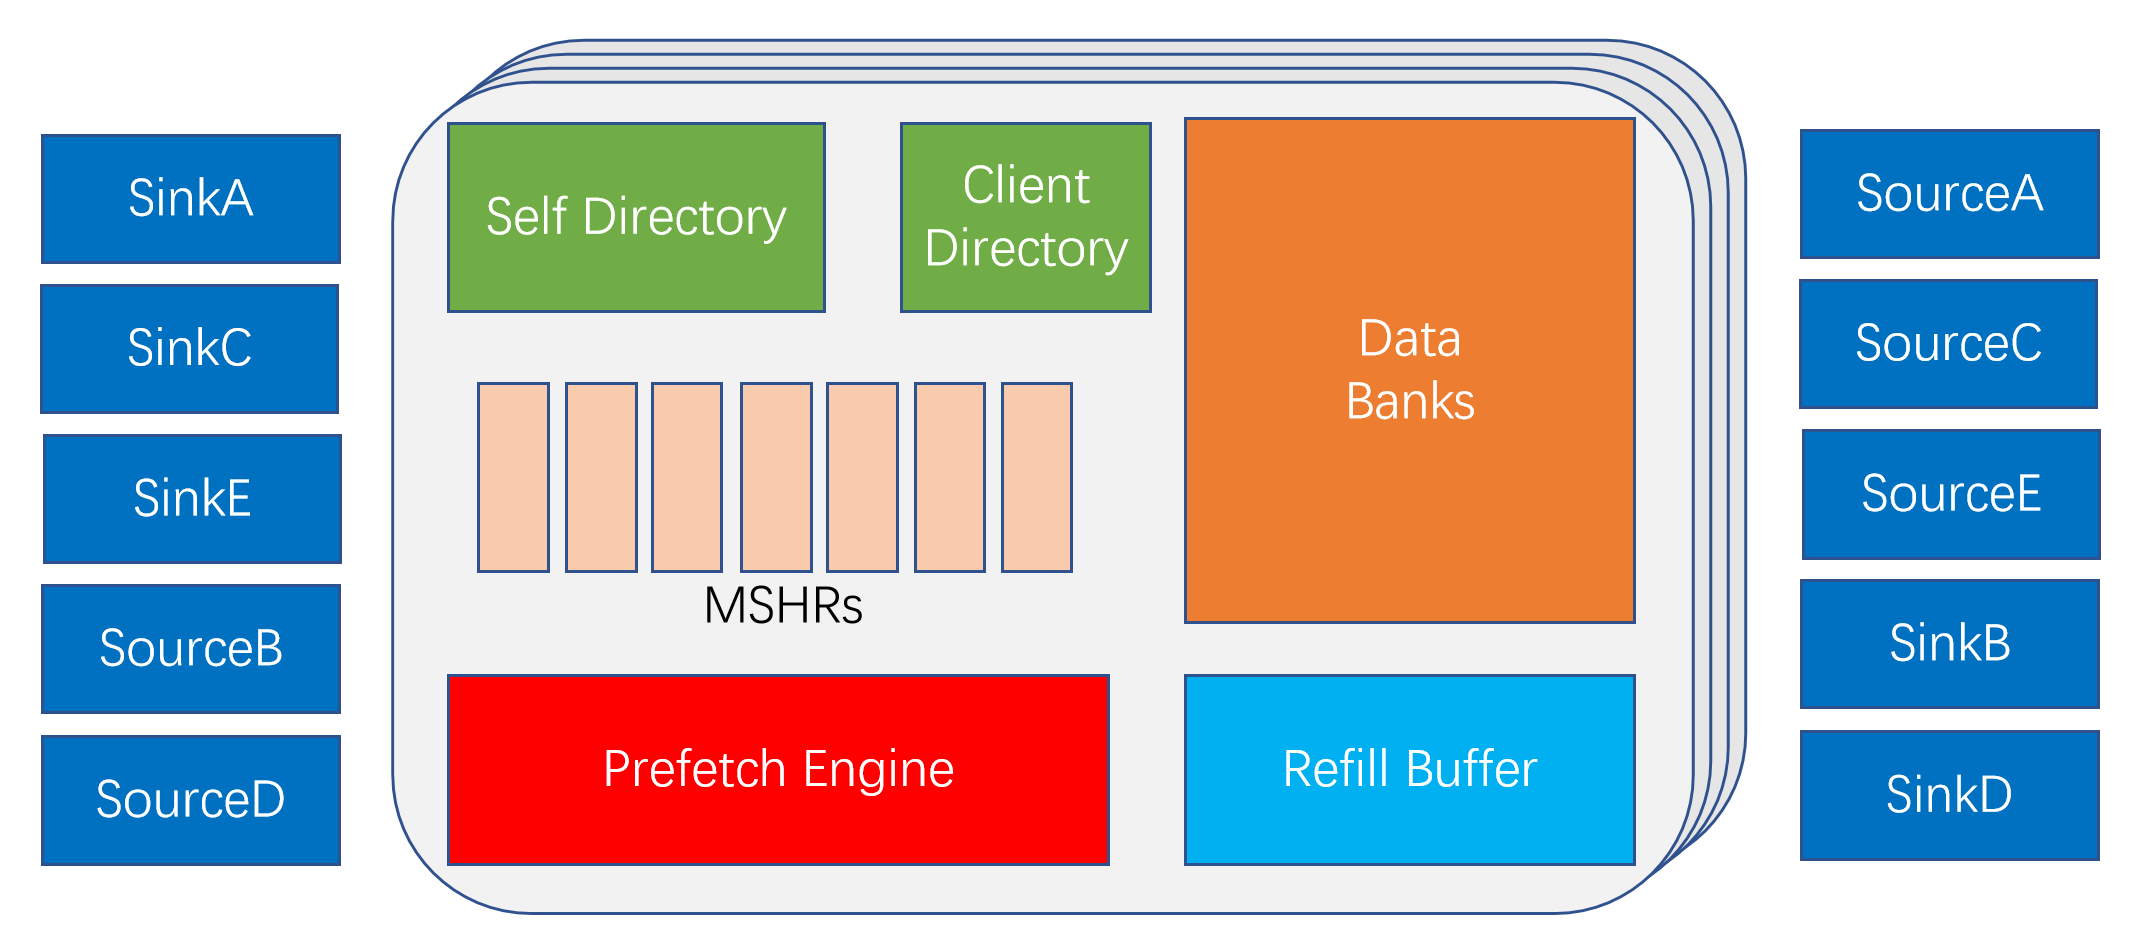
XiangShan은 비순차 다중 발행 아키텍처를 채택하여 프로그램에서 볼 수 있는 올바른 실행 순서를 유지하면서 여러 명령어를 동시에 디스패치하고 실행할 수 있습니다. Nanhu 세대에서 메모리 서브시스템은 두 개의 로드 파이프라인, 두 개의 스토어 주소 파이프라인, 두 개의 스토어 데이터 파이프라인을 포함합니다. 데이터 캐시는 사이클당 두 개의 64비트 읽기 연산을 지원하여 메모리 집약적인 워크로드에 추가 대역폭을 제공합니다. 개별 코어 위에서 Huancun은 공유 최종 레벨 캐시를 제공하여 여러 코어가 공통 캐시 계층에 접근할 수 있게 합니다.
가상 메모리 접근은 Translation Lookaside Buffer(TLB)를 통해 변환되며, 추가 L2 TLB가 추가 변환 용량을 제공합니다. 물리 메모리 접근 권한과 속성은 Physical Memory Protection(PMP) 및 Physical Memory Attributes(PMA) 메커니즘을 통해 검사됩니다. 프로세서 코어와 주변 시스템 간의 통신은 TileLink 인터커넥트 프로토콜을 통해 처리됩니다.
| 부분 | 옌치후 | 난후 |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| 실행 | 비순차, 다중 발행 | 비순차, 다중 발행 |
| 로드 파이프라인 | 2개 | 2개 |
| 스토어 파이프라인 | 주소 2개, 데이터 2개 | 주소 2개, 데이터 2개 |
| L1 데이터 캐시 | 64비트 읽기 포트 2개, 라인 폭 쓰기 포트 1개 | 64비트 읽기 포트 2개, 라인 폭 쓰기 포트 1개 |
| 최종 레벨 캐시 | Huancun, 공유 | Huancun, 공유 |
| 상호 연결 | TileLink | TileLink |
메모리 및 레지스터 맵
XiangShan의 기본 물리 주소 맵은 메인 메모리, 주변 장치 및 예약 영역을 포함한 시스템 구성 요소에 특정 주소 범위를 할당합니다. Physical Memory Attributes(PMA) 구성은 이러한 영역에 허용되는 접근 속성을 정의하여 각 주소 범위에서 수행할 수 있는 연산 유형을 결정합니다. 소프트웨어가 정의된 영역 밖의 주소에 접근하려고 하거나 해당 속성에 의해 금지된 연산을 수행하려고 하면 프로세서는 접근 폴트를 발생시킵니다. 이 메커니즘을 통해 하드웨어는 플랫폼의 물리 메모리 레이아웃과 접근 제한을 강제할 수 있습니다.
| 지역 | 주소 범위 |
|---|---|
| 주변 장치 공간 | 0x0000_0000 부터 0x7fff_ffff 까지 |
| DDR | 0x8000_0000 부터 0xf_ffff_ffff 까지 |
| CLINT | 0x3800_0000 부터 0x3800_ffff 까지 |
| 버스 오류 유닛 | 0x3801_0000에서 0x3801_ffff까지 |
| 디버그 모듈 | 0x3802_0000에서 0x3802_0fff까지 |
| L3 캐시 제어 | 0x3900_0000에서 0x3900_0fff까지 |
| PLIC | 0x3c00_0000에서 0x3fff_ffff까지 |
플랫폼 수준 인터럽트 컨트롤러(PLIC)는 소스 1-64를 통해 외부 인터럽트 요청을 받습니다. 소스 65와 66은 각각 코어 0과 코어 1이 생성하는 버스 오류 인터럽트용으로 예약되어 있습니다.
물리적 구현
XiangShan은 프로토타이핑을 넘어 물리적 실리콘 구현으로 발전했습니다. 첫 세대 설계인 Yanqihu는 2021년에 28 nm 제조 공정을 사용하여 테이프아웃을 완료했으며, 보고된 동작 주파수는 1.3 GHz이고 5.3 CoreMark/MHz입니다. 두 번째 세대인 Nanhu는 2023년에 14 nm 공정에서 2 GHz로 테이프아웃되었습니다. 이후 세대는 더욱 발전된 반도체 공정 노드와 더 높은 동작 주파수를 추구하며, 점점 더 뛰어난 프로세서 구현을 향한 프로젝트의 지속적인 개발을 반영합니다.
| 세대 | 보고된 수치 |
|---|---|
| Yanqihu | 28 nm, 1.3 GHz, 5.3 CoreMark/MHz, 2021년 테이프아웃 |
| Nanhu | 14 nm, 2 GHz, 2023년 테이프아웃 |
| Kunminghu | 작성 시점 기준 개발 중 |
| FPGA | 코어의 LUT 수는 공개되지 않음 |
부품 식별
XiangShan은 다양한 SoC 구현에 통합할 수 있는 오픈 소스 프로세서 설계입니다. XiangShan 기반 시스템을 식별하려면 일반적인 프로세서 식별자에 의존하지 않고 하드웨어 플랫폼을 조사해야 합니다. 먼저 보드 문서, SoC 사양 또는 칩 마킹에서 기반 구현을 식별합니다. 시스템에 접근할 수 있는 경우 부트 로그, 디바이스 트리 및 하드웨어 설명을 검사하여 ISA, 코어 수, 캐시 구성 및 벤더별 식별자를 포함한 프로세서 정보를 확인합니다. 보고되는 mvendorid, marchid 및 mimpid CSR도 플랫폼이 이들에 대해 의미 있는 값을 노출하는 경우 구현 식별에 도움이 될 수 있습니다.
메모리 맵은 디버그 모듈과 캐시 컨트롤러를 고정 주소에 배치하며, 이들이 플랫폼을 식별합니다.
| 표시 위치 | 확인 방법 |
|---|---|
| Yanqihu 및 Nanhu 보드 | 플랫폼 문서와 고정 주변장치 맵 |
| 연구 시스템 | 프로젝트 논문 및 릴리스 노트 |
| 소프트웨어 이미지 | 디바이스 트리와 디버그 모듈 베이스 주소 |
디스어셈블 및 디버깅
디버그 모듈은 RISC-V External Debug Support 0.13.2를 따르며 주변 공간의 고정 주소에 위치합니다. OpenOCD는 기본적으로 원격 bitbang 연결을 통해 이에 연결합니다.
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| 항목 | 값 |
|---|---|
| ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| 컴파일러 플래그 | Yanqihu의 경우 -march=rv64gc -mabi=lp64d, Nanhu의 경우 -march=rv64gcbk -mabi=lp64d, 빌드가 활성화하는 확장 기능 추가 |
| 디버그 모듈 | 0x3802_0000부터 0x3802_0fff까지, 프로토콜 0.13.2 |
| 프로그램 버퍼 | 16바이트, 추상 명령이 이를 사용 |
| 트리거 | 10개의 매치 제어 트리거 |
| misa (0x301) | ISA 및 활성화된 확장 |
| mvendorid (0xF11) | JEDEC 벤더 ID, 읽기 전용 |
| marchid (0xF12) | 마이크로아키텍처 ID, 읽기 전용 |
| mimpid (0xF13) | 구현 버전, 읽기 전용 |
| mhartid (0xF14) | 코드를 실행하는 hart, 읽기 전용 |
역사
중국과학원 계산기술연구소가 2019년에 XiangShan을 시작했으며, 첫 번째 세대 작업은 2020년 6월에 시작되었습니다. Peng Cheng Laboratory가 물리 설계의 상당 부분을 수행했으며, 이는 로직을 공장에서 생산할 수 있는 레이아웃으로 변환하는 단계입니다.
팀은 주요 컴퓨터 아키텍처 학회인 MICRO 2022에서 개발 방법을 발표했습니다. 업계 파트너와 함께 설립된 비영리 단체인 Beijing Institute of Open Source Chip이 현재 개발을 조정하고 있습니다.
사용되는 곳
XiangShan은 휴대폰과 서버에서 볼 수 있는 상용 애플리케이션 프로세서의 성능을 목표로 합니다. 연구자들은 고급 프로세서 설계를 연구하는 데 이를 사용하며, 프로젝트는 시뮬레이션, 검증 및 성능 분석 도구를 코어와 함께 공개합니다.