XiangShan
RISC-VエコシステムXiangShanは、中国科学院計算技術研究所で2019年に始まった、Chiselで書かれた高性能アウトオブオーダーRV64コアです。その世代は湖の名前をとっており、2021年にテープアウトされた雁栖湖から、南湖、昆明湖へと続きます。
概要
| 仕様 | 値 |
|---|---|
| ISAサポート | Yanqihu:RV64GC、Nanhu:RV64GCBK |
| マイクロアーキテクチャ | アウトオブオーダー、マルチイシュー。世代は Yanqihu、Nanhu、Kunminghu |
| 性能密度 | 1.3 GHzで5.3 CoreMark/MHz(Yanqihu) |
| リソースフットプリント | ASIC 向け。プロジェクトは FPGA の LUT 数を公開していない |
| クロックドメイン | 28 nmで1.3 GHz(Yanqihu)、14 nmで2 GHz(Nanhu、2023年テープアウト) |
XiangShanは、64ビット命令セットアーキテクチャを実装したオープンソースの高性能RISC-Vプロセッサです。そのコアはアウトオブオーダー実行を採用しており、命令を元のプログラム順序とは異なる順序で処理できます。このアプローチにより、他の命令が依存関係の解決を待っている間に独立した操作を実行することで、プロセッサは命令レベルの並列性を活用できます。ハードウェアはScala上に構築されたハードウェア構築言語であるChiselで記述され、Mulan Permissive Software License, Version 2の下で配布されています。
この名前は北京西部の公園である香山を意味する中国語で、各世代の設計は湖の名前を取っています。第一世代のYanqihuは2021年に28ナノメートルプロセスでテープアウトされ、1.3 GHzで動作し、5.3 CoreMark/MHzを達成しました。テープアウトとは、完成した設計を製造のために工場へ送ることを意味します。Nanhuは第二世代で、2023年に14 nmで2 GHz、RV64GCBKとしてテープアウトされました。第三世代のKunminghuは現在活発に開発中です。
マイクロアーキテクチャ

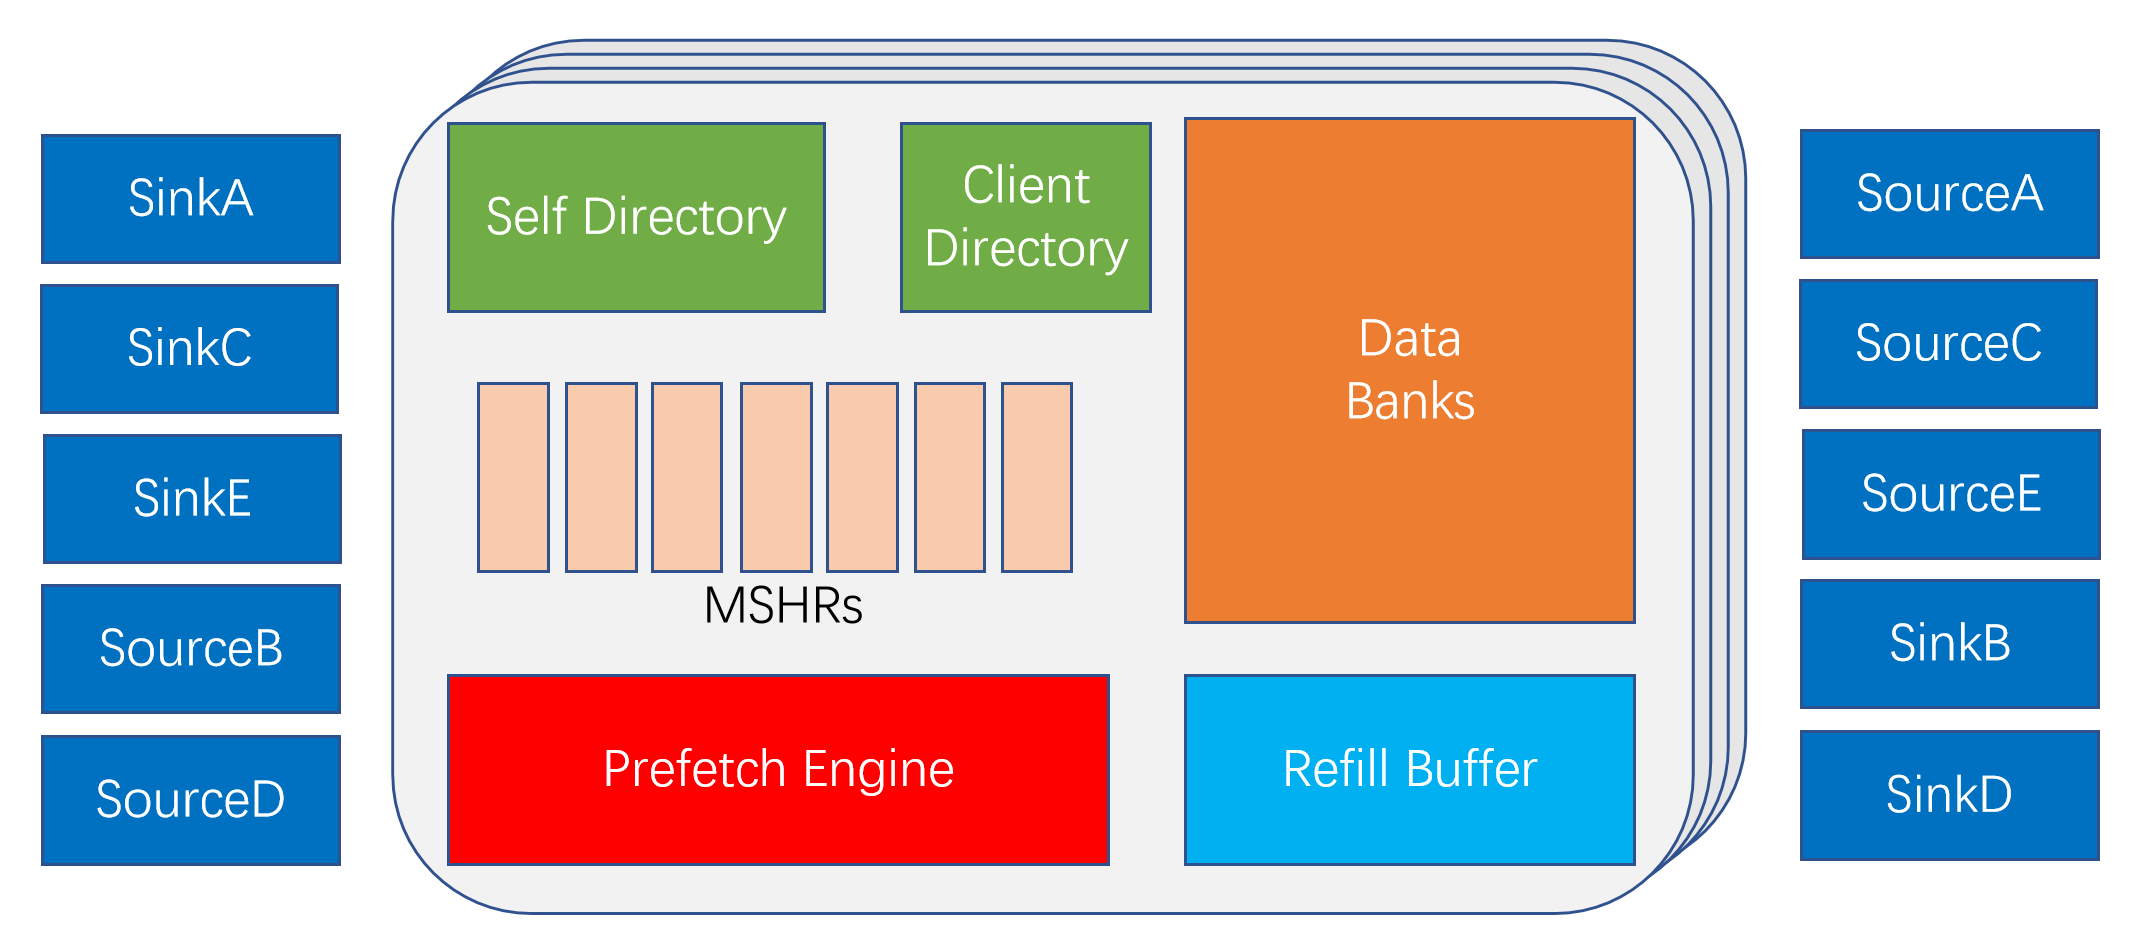
XiangShanはアウトオブオーダーのマルチ発行アーキテクチャを採用しており、プログラムから見える正しい実行順序を維持しながら、複数の命令を同時にディスパッチおよび実行できます。Nanhu世代では、メモリサブシステムに2つのロードパイプライン、2つのストアアドレスパイプライン、2つのストアデータパイプラインが含まれています。そのデータキャッシュはサイクルあたり2つの64ビット読み取り操作をサポートし、メモリ集約型のワークロードに追加の帯域幅を提供します。個々のコアの上位では、Huancunが共有最終レベルキャッシュを提供し、複数のコアが共通のキャッシュ階層にアクセスできるようにします。
仮想メモリアクセスはTranslation Lookaside Buffer(TLB)を通じて変換され、追加のL2 TLBがさらなる変換容量を提供します。物理メモリアクセスの権限と属性は、Physical Memory Protection(PMP)およびPhysical Memory Attributes(PMA)メカニズムを通じてチェックされます。プロセッサコアと周囲のシステム間の通信は、TileLinkインターコネクトプロトコルを通じて処理されます。
| パート | 燕栖湖 | 南湖 |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| 実行 | アウトオブオーダー、マルチイシュー | アウトオブオーダー、マルチイシュー |
| ロードパイプライン | 2本 | 2本 |
| ストアパイプライン | アドレス2本、データ2本 | アドレス2本、データ2本 |
| L1データキャッシュ | 64ビット読み出しポート2本、ラインバイト書き込みポート1本 | 64ビット読み出しポート2本、ラインバイト書き込みポート1本 |
| 最終レベルキャッシュ | Huancun、共有 | Huancun、共有 |
| 相互接続 | TileLink | TileLink |
メモリとレジスタマップ
XiangShanのデフォルトの物理アドレスマップは、メインメモリ、周辺デバイス、予約領域を含むシステムコンポーネントに特定のアドレス範囲を割り当てます。Physical Memory Attributes(PMA)構成は、これらの領域に対して許可されるアクセス属性を定義し、各アドレス範囲で実行できる操作の種類を決定します。ソフトウェアが定義された領域外のアドレスにアクセスしようとしたり、対応する属性によって禁止された操作を実行しようとしたりすると、プロセッサはアクセスフォールトを発生させます。このメカニズムにより、ハードウェアはプラットフォームの物理メモリレイアウトとアクセス制限を強制できます。
| 地域 | アドレス範囲 |
|---|---|
| ペリフェラル空間 | 0x0000_0000 から 0x7fff_ffff |
| DDR | 0x8000_0000 から 0xf_ffff_ffff |
| CLINT | 0x3800_0000 から 0x3800_ffff |
| バスエラーユニット | 0x3801_0000 から 0x3801_ffff |
| デバッグモジュール | 0x3802_0000 から 0x3802_0fff |
| L3キャッシュ制御 | 0x3900_0000 から 0x3900_0fff |
| PLIC | 0x3c00_0000 から 0x3fff_ffff |
プラットフォームレベル割り込みコントローラ(PLIC)は、ソース1-64を通じて外部割り込み要求を受け取ります。ソース65と66は、それぞれコア0とコア1が生成するバスエラー割り込み用に予約されています。
物理実装
XiangShanはプロトタイピングを超えて物理的なシリコン実装へと進展しました。その第一世代設計であるYanqihuは、2021年に28 nm製造プロセスを用いてテープアウトを完了し、報告されている動作周波数は1.3 GHz、5.3 CoreMark/MHzです。第二世代のNanhuは、2023年に14 nmプロセスで2 GHzにてテープアウトされました。以降の世代はより先進的な半導体プロセスノードとより高い動作周波数を追求しており、より高性能なプロセッサ実装に向けたプロジェクトの継続的な開発を反映しています。
| 世代 | 報告値 |
|---|---|
| Yanqihu | 28 nm、1.3 GHz、5.3 CoreMark/MHz、2021年にテープアウト |
| Nanhu | 14 nm、2 GHz、2023年にテープアウト |
| Kunminghu | 執筆時点では開発中 |
| FPGA | コアのLUT数は公開されていない |
パーツの識別
XiangShanは、さまざまなSoC実装に統合できるオープンソースのプロセッサ設計です。XiangShanベースのシステムを識別するには、汎用のプロセッサ識別子に頼るのではなく、ハードウェアプラットフォームを調べる必要があります。まず、ボードのドキュメント、SoC仕様、またはチップのマーキングから基盤となる実装を特定します。システムにアクセスできる場合は、そのブートログ、デバイスツリー、ハードウェア記述を調べて、ISA、コア数、キャッシュ構成、ベンダー固有の識別子などのプロセッサ情報を確認します。報告されるmvendorid、marchid、mimpidのCSRも、プラットフォームがそれらに意味のある値を公開している場合には、実装の識別に役立ちます。
メモリマップは、デバッグモジュールとキャッシュコントローラを固定アドレスに配置しており、これらがプラットフォームを識別します。
| 表示場所 | 確認方法 |
|---|---|
| YanqihuボードとNanhuボード | プラットフォームのドキュメントと固定ペリフェラルマップ |
| 研究システム | プロジェクトの論文とリリースノート |
| ソフトウェアイメージ | デバイスツリーとデバッグモジュールのベースアドレス |
逆アセンブルとデバッグ
デバッグモジュールはRISC-V External Debug Support 0.13.2に準拠し、周辺空間の固定アドレスに配置されています。OpenOCDはデフォルトでリモートbitbang接続を介してそれに接続します。
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| 項目 | 値 |
|---|---|
| ISA | Yanqihu:RV64GC、Nanhu:RV64GCBK |
| コンパイラフラグ | Yanqihu には -march=rv64gc -mabi=lp64d、Nanhu には -march=rv64gcbk -mabi=lp64d、ビルドが有効にする拡張機能を追加 |
| デバッグモジュール | 0x3802_0000から0x3802_0fff、プロトコル0.13.2 |
| プログラムバッファ | 16バイト、抽象コマンドがこれを使用 |
| トリガー | 10個のマッチ制御トリガー |
| misa (0x301) | ISAと有効な拡張 |
| mvendorid (0xF11) | JEDECベンダーID、読み取り専用 |
| marchid(0xF12) | マイクロアーキテクチャID、読み取り専用 |
| mimpid(0xF13) | 実装バージョン、読み取り専用 |
| mhartid(0xF14) | コードを実行するhart、読み取り専用 |
歴史
中国科学院計算技術研究所が2019年にXiangShanを開始し、第一世代の作業は2020年6月に始まりました。Peng Cheng Laboratoryが物理設計の大部分を担当しました。これはロジックを工場が製造できるレイアウトに変換する工程です。
チームは主要なコンピュータアーキテクチャ会議であるMICRO 2022で開発手法を発表しました。業界パートナーとともに設立された非営利団体であるBeijing Institute of Open Source Chipが現在、開発を調整しています。
使用されている場所
XiangShanは、携帯電話やサーバーに見られるような商用アプリケーションプロセッサの性能を目標としています。研究者はハイエンドプロセッサ設計の研究にこれを使用しており、プロジェクトはシミュレーション、検証、性能分析ツールをコアとともに公開しています。