XiangShan
Экосистема RISC-VXiangShan — это высокопроизводительное ядро RV64 с внеочередным выполнением, написанное на Chisel, начатое в 2019 году в Институте вычислительной техники Китайской академии наук. Его поколения носят названия озёр: от Yanqihu, выпущенного в 2021 году, до Nanhu и Kunminghu.
Обзор
| Спецификация | Значение |
|---|---|
| Поддержка ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Микроархитектура | Внеочередное выполнение, множественная выдача; поколения — Yanqihu, Nanhu и Kunminghu |
| Плотность производительности | 5.3 CoreMark/MHz при 1.3 GHz (Yanqihu) |
| Ресурсоёмкость | Ориентирован на ASIC; проект не публикует количество LUT для FPGA |
| Тактовый домен | 1.3 GHz на 28 нм (Yanqihu), 2 GHz на 14 нм (Nanhu, tape-out 2023) |
XiangShan — это открытый высокопроизводительный процессор RISC-V, реализующий 64-битную архитектуру набора инструкций. Его ядра используют внеочередное выполнение, позволяя обрабатывать инструкции в порядке, отличном от их исходной последовательности в программе. Такой подход позволяет процессору использовать параллелизм на уровне инструкций, выполняя независимые операции, пока другие инструкции ожидают разрешения своих зависимостей. Аппаратное обеспечение описано на Chisel, языке конструирования аппаратуры, построенном на Scala, и распространяется по лицензии Mulan Permissive Software License, Version 2.
Название по-китайски означает «Благоухающие холмы» — парк на западе Пекина, и каждое поколение дизайна получает имя озера. Первое поколение, Yanqihu, было отправлено в производство (tape-out) в 2021 году по 28-нанометровому техпроцессу и работало на частоте 1,3 ГГц, достигая 5,3 CoreMark/MHz. Tape-out означает отправку готового дизайна на завод для изготовления. Nanhu — второе поколение, отправленное в производство в 2023 году по техпроцессу 14 нм на частоте 2 ГГц с RV64GCBK. Kunminghu, третье, находится в активной разработке.
Микроархитектура

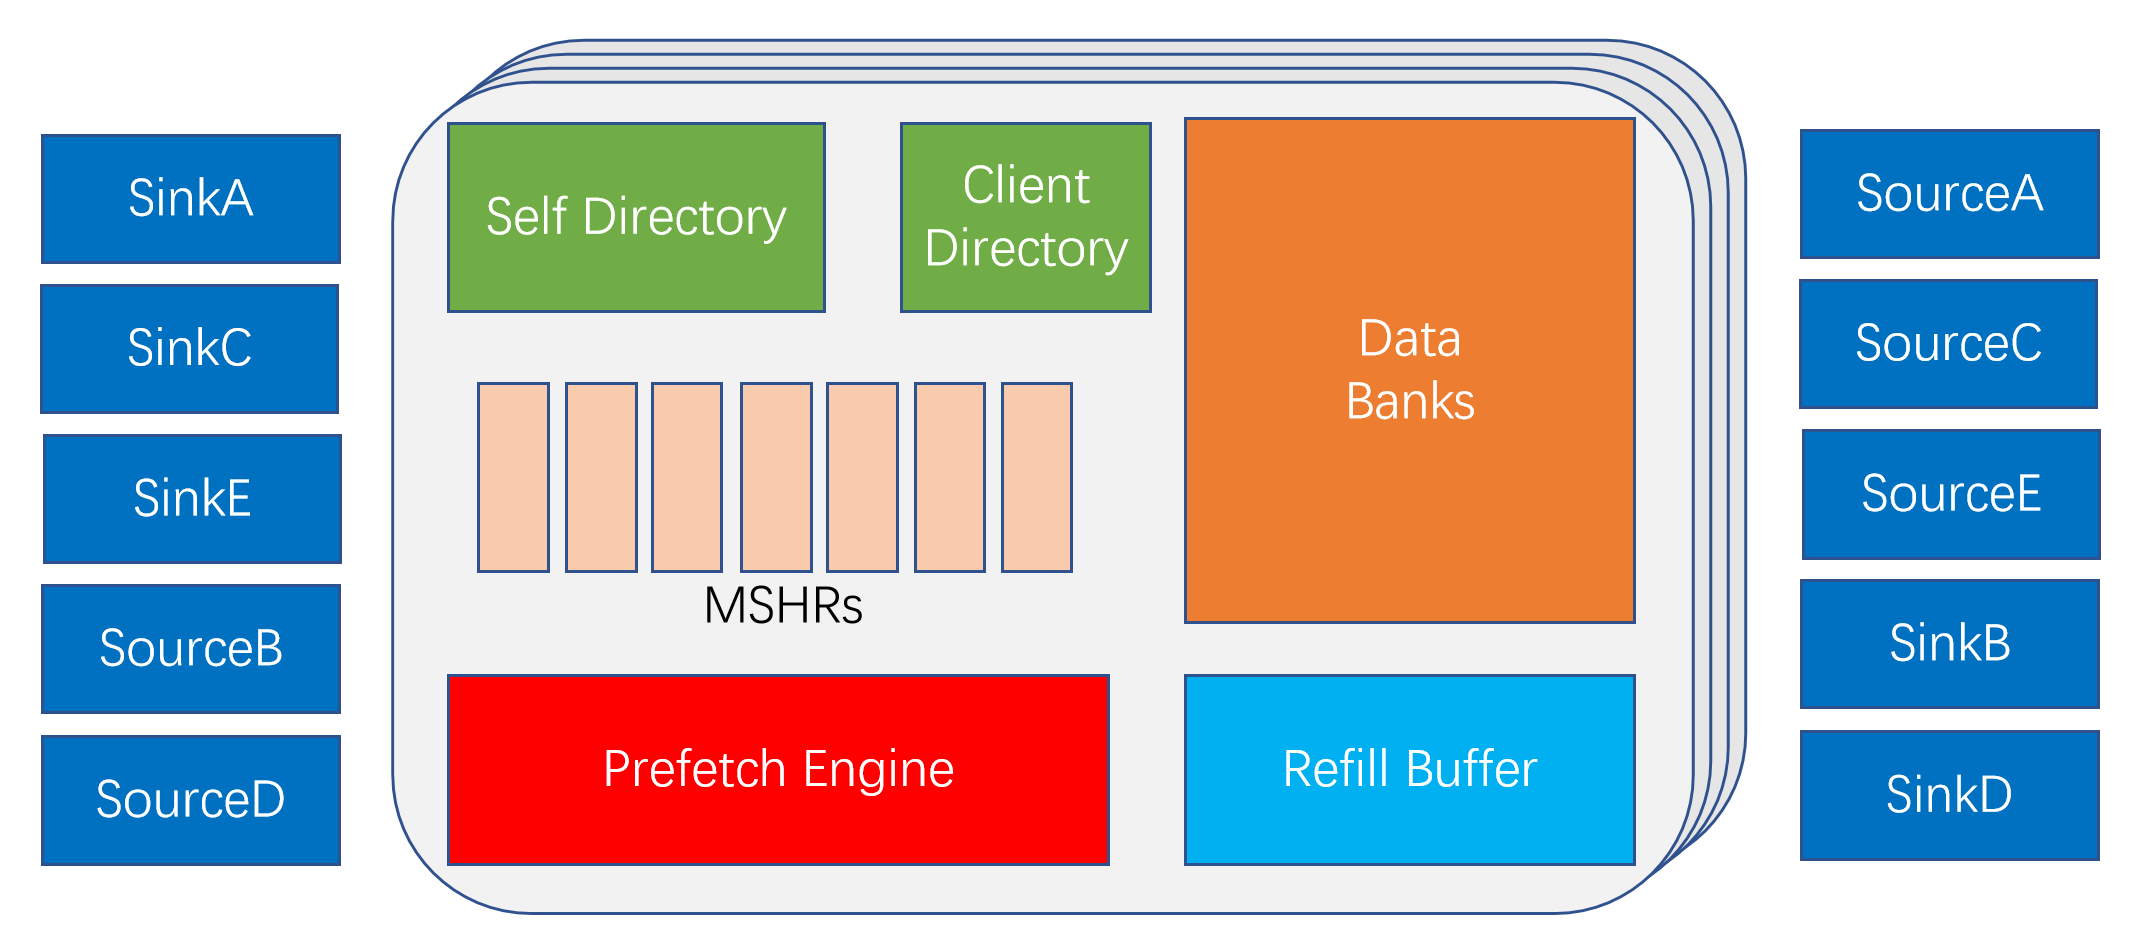
XiangShan использует внеочередную архитектуру с множественной выдачей, позволяя одновременно отправлять и выполнять несколько инструкций при сохранении правильного порядка выполнения, видимого программе. В поколении Nanhu подсистема памяти включает два конвейера загрузки, два конвейера адресов сохранения и два конвейера данных сохранения. Его кэш данных поддерживает две 64-битные операции чтения за такт, обеспечивая дополнительную пропускную способность для нагрузок с интенсивным использованием памяти. Над отдельными ядрами Huancun обеспечивает общий кэш последнего уровня, позволяя нескольким ядрам обращаться к общей иерархии кэша.
Обращения к виртуальной памяти транслируются через Translation Lookaside Buffer (TLB), а дополнительный TLB L2 обеспечивает дополнительную ёмкость трансляции. Права и атрибуты доступа к физической памяти проверяются механизмами Physical Memory Protection (PMP) и Physical Memory Attributes (PMA). Связь между ядрами процессора и окружающей системой осуществляется через протокол соединения TileLink.
| Часть | Yanqihu | Nanhu |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| Исполнение | Внеочередное, многовыдача | Внеочередное, многовыдача |
| Конвейеры загрузки | Два | Два |
| Конвейеры сохранения | Два адресных, два данных | Два адресных, два данных |
| Кэш данных L1 | Два 64-битных порта чтения, один порт записи шириной в строку | Два 64-битных порта чтения, один порт записи шириной в строку |
| Кэш последнего уровня | Huancun, общий | Huancun, общий |
| Interconnect | TileLink | TileLink |
Карта памяти и регистров
Карта физических адресов XiangShan по умолчанию назначает определённые диапазоны адресов компонентам системы, включая основную память, периферийные устройства и зарезервированные области. Конфигурация Physical Memory Attributes (PMA) определяет разрешённые свойства доступа для этих областей, определяя, какие типы операций могут выполняться в каждом диапазоне адресов. Когда программное обеспечение пытается обратиться к адресу за пределами определённых областей или выполняет операцию, запрещённую соответствующими атрибутами, процессор вызывает ошибку доступа. Этот механизм позволяет аппаратному обеспечению обеспечивать соблюдение физической карты памяти платформы и ограничений доступа.
| Регион | Диапазон адресов |
|---|---|
| Периферийное пространство | 0x0000_0000 до 0x7fff_ffff |
| DDR | 0x8000_0000 до 0xf_ffff_ffff |
| CLINT | 0x3800_0000 до 0x3800_ffff |
| Блок ошибки шины | 0x3801_0000 до 0x3801_ffff |
| Модуль отладки | 0x3802_0000 до 0x3802_0fff |
| Управление кэшем L3 | 0x3900_0000 до 0x3900_0fff |
| PLIC | 0x3c00_0000 до 0x3fff_ffff |
Контроллер прерываний уровня платформы (PLIC) принимает внешние запросы прерываний через источники 1-64. Источники 65 и 66 зарезервированы для прерываний ошибки шины, генерируемых ядром 0 и ядром 1 соответственно.
Физическая реализация
XiangShan вышел за рамки прототипирования и перешёл к физической реализации на кремнии. Его первое поколение, Yanqihu, завершило tape-out в 2021 году с использованием 28-нм производственного техпроцесса, с заявленной рабочей частотой 1,3 ГГц и 5,3 CoreMark/MHz. Второе поколение, Nanhu, было отправлено в производство в 2023 году по 14-нм техпроцессу на частоте 2 ГГц. Последующие поколения осваивали более передовые технологические узлы полупроводников и более высокие рабочие частоты, что отражает непрерывное развитие проекта в направлении всё более производительных реализаций процессора.
| Поколение | Заявленная цифра |
|---|---|
| Yanqihu | 28 нм, 1,3 ГГц, 5,3 CoreMark/МГц, изготовлен в 2021 году |
| Nanhu | 14 нм, 2 ГГц, изготовлен в 2023 году |
| Kunminghu | На момент написания находится в разработке |
| FPGA | Количество LUT для ядра не опубликовано |
Определение части
XiangShan — это открытый проект процессора, который можно интегрировать в различные реализации SoC. Для идентификации системы на основе XiangShan необходимо изучить аппаратную платформу, а не полагаться на общий идентификатор процессора. Начните с документации платы, спецификаций SoC или маркировки чипа, чтобы определить базовую реализацию. Если система доступна, изучите её журналы загрузки, дерево устройств и описание аппаратного обеспечения для получения информации о процессоре, включая ISA, количество ядер, конфигурацию кэша и идентификаторы, специфичные для производителя. Сообщаемые CSR mvendorid, marchid и mimpid также могут помочь идентифицировать реализацию, при условии что платформа предоставляет для них осмысленные значения.
Карта памяти размещает модуль отладки и контроллеры кэша по фиксированным адресам, которые идентифицируют платформу.
| Где встречается | Как подтвердить |
|---|---|
| Платы Yanqihu и Nanhu | Документация платформы и фиксированная карта периферийных устройств |
| Исследовательские системы | Статьи проекта и примечания к выпуску |
| Образы программного обеспечения | Дерево устройств и базовый адрес модуля отладки |
Дисассемблирование и отладка
Модуль отладки соответствует спецификации RISC-V External Debug Support 0.13.2 и расположен по фиксированному адресу в периферийном пространстве. OpenOCD по умолчанию подключается к нему через соединение remote bitbang.
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| Элемент | Значение |
|---|---|
| ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Флаги компилятора | -march=rv64gc -mabi=lp64d для Yanqihu; -march=rv64gcbk -mabi=lp64d для Nanhu, добавьте расширения, которые включает сборка |
| Модуль отладки | 0x3802_0000 до 0x3802_0fff, протокол 0.13.2 |
| Буфер программы | 16 байт, его используют абстрактные команды |
| Триггеры | 10 триггеров управления совпадением |
| misa (0x301) | ISA и включённые расширения |
| mvendorid (0xF11) | идентификатор производителя JEDEC, только для чтения |
| marchid (0xF12) | идентификатор микроархитектуры, только для чтения |
| mimpid (0xF13) | версия реализации, только для чтения |
| mhartid (0xF14) | hart, выполняющий код, только для чтения |
История
Институт вычислительной техники Китайской академии наук начал XiangShan в 2019 году, а работа над первым поколением началась в июне 2020 года. Peng Cheng Laboratory выполнила большую часть физического проектирования — этапа, который превращает логику в макет, который может произвести фабрика.
Команда представила свои методы разработки на MICRO 2022, крупной конференции по компьютерной архитектуре. Beijing Institute of Open Source Chip, некоммерческая организация, основанная с отраслевыми партнёрами, теперь координирует разработку.
Где он используется
XiangShan нацелен на производительность коммерческих прикладных процессоров, тех, что используются в телефонах и серверах. Исследователи используют его для изучения проектирования процессоров высокого класса, а проект публикует свои инструменты моделирования, верификации и анализа производительности вместе с ядром.