XiangShan
Ecosistema RISC-VXiangShan è un core RV64 out-of-order ad alte prestazioni scritto in Chisel, avviato nel 2019 presso l'Istituto di tecnologia informatica dell'Accademia cinese delle scienze. Le sue generazioni prendono nomi di laghi, da Yanqihu, tape-out nel 2021, a Nanhu e Kunminghu.
Panoramica
| Specifica | Valore |
|---|---|
| Supporto ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Microarchitettura | Fuori ordine, multi-issue; le generazioni sono Yanqihu, Nanhu e Kunminghu |
| Densità di prestazioni | 5,3 CoreMark/MHz a 1,3 GHz (Yanqihu) |
| Impronta delle risorse | Orientato agli ASIC; il progetto non pubblica alcun conteggio di LUT FPGA |
| Dominio di clock | 1,3 GHz su 28 nm (Yanqihu), 2 GHz su 14 nm (Nanhu, tape-out 2023) |
XiangShan è un processore RISC-V open source ad alte prestazioni che implementa l'architettura del set di istruzioni a 64 bit. I suoi core impiegano l'esecuzione out-of-order, consentendo di elaborare le istruzioni in un ordine diverso dalla loro sequenza originale nel programma. Questo approccio consente al processore di sfruttare il parallelismo a livello di istruzione eseguendo operazioni indipendenti mentre altre istruzioni attendono la risoluzione delle proprie dipendenze. L'hardware è descritto in Chisel, un linguaggio di costruzione hardware basato su Scala, ed è distribuito con la Mulan Permissive Software License, Versione 2.
Il nome è il termine cinese per Colline Profumate, un parco nella parte occidentale di Pechino, e ogni generazione del design prende il nome di un lago. La prima generazione, Yanqihu, è stata finalizzata nel 2021 su un processo a 28 nanometri e funzionava a 1,3 GHz, raggiungendo 5,3 CoreMark/MHz. Finalizzare (tape-out) significa inviare un design completato a una fabbrica per la produzione. Nanhu è la seconda generazione, finalizzata nel 2023 su 14 nm a 2 GHz con RV64GCBK. Kunminghu, la terza, è in sviluppo attivo.
Microarchitettura

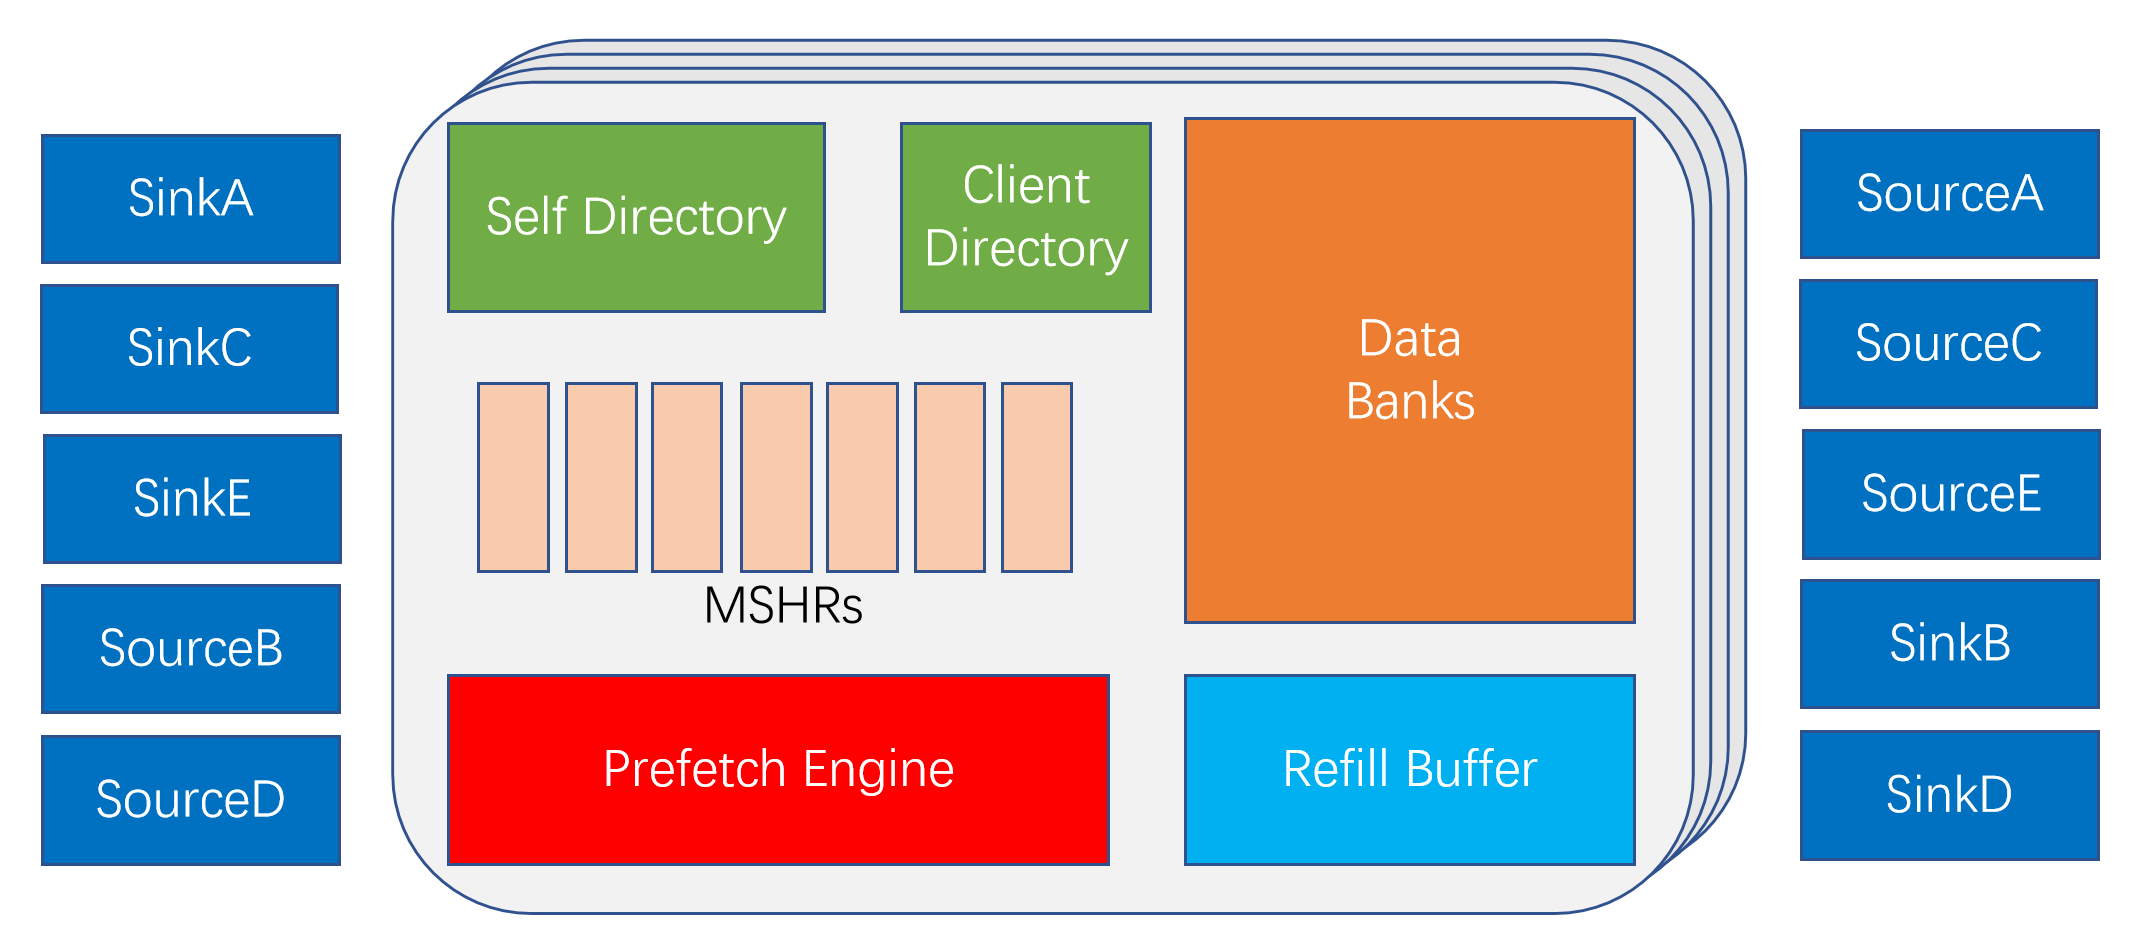
XiangShan impiega un'architettura out-of-order a emissione multipla, che consente a più istruzioni di essere inviate ed eseguite contemporaneamente mantenendo il corretto ordine di esecuzione visibile al programma. Nella generazione Nanhu, il sottosistema di memoria include due pipeline di caricamento, due pipeline di indirizzo di memorizzazione e due pipeline di dati di memorizzazione. La sua cache dati supporta due operazioni di lettura a 64 bit per ciclo, fornendo larghezza di banda aggiuntiva per carichi di lavoro intensivi in memoria. Al di sopra dei singoli core, Huancun fornisce una cache di ultimo livello condivisa, consentendo a più core di accedere a una gerarchia di cache comune.
Gli accessi alla memoria virtuale vengono tradotti tramite un Translation Lookaside Buffer (TLB), con un TLB L2 aggiuntivo che fornisce ulteriore capacità di traduzione. I permessi e gli attributi di accesso alla memoria fisica vengono verificati tramite i meccanismi Physical Memory Protection (PMP) e Physical Memory Attributes (PMA). La comunicazione tra i core del processore e il sistema circostante è gestita tramite il protocollo di interconnessione TileLink.
| Parte | Yanqihu | Nanhu |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| Esecuzione | Fuori ordine, multi-issue | Fuori ordine, multi-issue |
| Pipeline di load | Due | Due |
| Pipeline di store | Due di indirizzo, due di dati | Due di indirizzo, due di dati |
| Cache dati L1 | Due porte di lettura a 64 bit, una porta di scrittura larga una linea | Due porte di lettura a 64 bit, una porta di scrittura larga una linea |
| Cache di ultimo livello | Huancun, condivisa | Huancun, condivisa |
| Interconnessione | TileLink | TileLink |
Mappa di memoria e registri
La mappa degli indirizzi fisici predefinita di XiangShan assegna intervalli di indirizzi specifici ai componenti del sistema, tra cui memoria principale, dispositivi periferici e regioni riservate. La configurazione Physical Memory Attributes (PMA) definisce le proprietà di accesso consentite per queste regioni, determinando quali tipi di operazioni possono essere eseguite in ciascun intervallo di indirizzi. Quando il software tenta di accedere a un indirizzo al di fuori delle regioni definite o esegue un'operazione vietata dagli attributi corrispondenti, il processore genera un errore di accesso. Questo meccanismo consente all'hardware di imporre il layout della memoria fisica e le restrizioni di accesso della piattaforma.
| Regione | Intervallo di indirizzi |
|---|---|
| Spazio periferico | da 0x0000_0000 a 0x7fff_ffff |
| DDR | da 0x8000_0000 a 0xf_ffff_ffff |
| CLINT | da 0x3800_0000 a 0x3800_ffff |
| Unità di errore del bus | da 0x3801_0000 a 0x3801_ffff |
| Modulo di debug | da 0x3802_0000 a 0x3802_0fff |
| Controllo della cache L3 | da 0x3900_0000 a 0x3900_0fff |
| PLIC | da 0x3c00_0000 a 0x3fff_ffff |
Il Platform-Level Interrupt Controller (PLIC) riceve richieste di interrupt esterne tramite le sorgenti da 1 a 64. Le sorgenti 65 e 66 sono riservate agli interrupt di errore di bus generati rispettivamente dal core 0 e dal core 1.
Implementazione fisica
XiangShan è andato oltre la prototipazione fino all'implementazione fisica in silicio. Il suo design di prima generazione, Yanqihu, ha completato il tape-out nel 2021 utilizzando un processo produttivo a 28 nm, con una frequenza operativa dichiarata di 1,3 GHz e 5,3 CoreMark/MHz. La seconda generazione, Nanhu, è stata finalizzata nel 2023 su un processo a 14 nm a 2 GHz. Le generazioni successive hanno puntato a nodi di processo semiconduttore più avanzati e a frequenze operative più elevate, riflettendo lo sviluppo continuo del progetto verso implementazioni di processori sempre più capaci.
| Generazione | Cifra riportata |
|---|---|
| Yanqihu | 28 nm, 1.3 GHz, 5.3 CoreMark/MHz, realizzato in 2021 |
| Nanhu | 14 nm, 2 GHz, realizzato in 2023 |
| Kunminghu | In sviluppo al momento della stesura |
| FPGA | Nessun conteggio di LUT pubblicato per il core |
Identificazione del componente
XiangShan è un design di processore open source che può essere integrato in diverse implementazioni SoC. Identificare un sistema basato su XiangShan richiede di esaminare la piattaforma hardware anziché affidarsi a un identificatore generico di processore. Iniziare dalla documentazione della scheda, dalle specifiche del SoC o dalle marcature del chip per identificare l'implementazione sottostante. Se il sistema è accessibile, ispezionare i log di avvio, il device tree e la descrizione hardware per informazioni sul processore, inclusi ISA, numero di core, configurazione delle cache e identificatori specifici del fornitore. Anche i CSR mvendorid, marchid e mimpid riportati possono aiutare a identificare l'implementazione, a condizione che la piattaforma esponga valori significativi per essi.
La mappa di memoria colloca il modulo di debug e i controller delle cache a indirizzi fissi, il che identifica la piattaforma.
| Dove appare | Come confermare |
|---|---|
| Schede Yanqihu e Nanhu | Documentazione della piattaforma e mappa fissa delle periferiche |
| Sistemi di ricerca | Documenti del progetto e note di rilascio |
| Immagini software | Device tree e indirizzo base del modulo di debug |
Disassemblaggio e debug
Il modulo di debug segue RISC-V External Debug Support 0.13.2 e si trova a un indirizzo fisso nello spazio delle periferiche. OpenOCD vi si connette per impostazione predefinita tramite una connessione remote bitbang.
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| Elemento | Valore |
|---|---|
| ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Flag del compilatore | -march=rv64gc -mabi=lp64d per Yanqihu; -march=rv64gcbk -mabi=lp64d per Nanhu, aggiungi le estensioni abilitate dalla build |
| Modulo di debug | da 0x3802_0000 a 0x3802_0fff, protocollo 0.13.2 |
| Buffer di programma | 16 byte, i comandi astratti lo utilizzano |
| Trigger | 10 trigger di controllo della corrispondenza |
| misa (0x301) | ISA ed estensioni abilitate |
| mvendorid (0xF11) | ID fornitore JEDEC, sola lettura |
| marchid (0xF12) | ID microarchitettura, sola lettura |
| mimpid (0xF13) | versione di implementazione, sola lettura |
| mhartid (0xF14) | hart che esegue il codice, sola lettura |
Storia
L'Istituto di Tecnologia Informatica dell'Accademia Cinese delle Scienze ha avviato XiangShan nel 2019, e il lavoro sulla prima generazione è iniziato nel giugno 2020. Il Peng Cheng Laboratory ha realizzato gran parte del design fisico, la fase che trasforma la logica in un layout che una fabbrica può produrre.
Il team ha presentato i propri metodi di sviluppo alla MICRO 2022, una delle principali conferenze di architettura dei computer. Il Beijing Institute of Open Source Chip, un'organizzazione senza scopo di lucro fondata con partner industriali, ora coordina lo sviluppo.
Dove viene usato
XiangShan punta alle prestazioni dei processori applicativi commerciali, del tipo presente in telefoni e server. I ricercatori lo utilizzano per studiare la progettazione di processori di fascia alta, e il progetto pubblica i propri strumenti di simulazione, verifica e analisi delle prestazioni insieme al core.