XiangShan
RISC-V इकोसिस्टमXiangShan एक उच्च-प्रदर्शन आउट-ऑफ-ऑर्डर RV64 कोर है जो Chisel में लिखा गया है, जिसकी शुरुआत 2019 में चीनी विज्ञान अकादमी के कंप्यूटिंग प्रौद्योगिकी संस्थान में हुई थी। इसकी पीढ़ियाँ झीलों के नाम लेती हैं, 2021 में टेप-आउट हुए Yanqihu से लेकर Nanhu और Kunminghu तक।
अवलोकन
| विनिर्देश | मान |
|---|---|
| ISA समर्थन | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| माइक्रोआर्किटेक्चर | आउट-ऑफ-ऑर्डर, मल्टी-इश्यू; पीढ़ियाँ यानकिहू, नानहू और कुनमिंगहू हैं |
| प्रदर्शन घनत्व | 5.3 CoreMark/MHz at 1.3 GHz (Yanqihu) |
| संसाधन पदचिह्न | ASIC-केंद्रित; परियोजना कोई FPGA LUT संख्या प्रकाशित नहीं करती |
| क्लॉक डोमेन | 1.3 GHz on 28 nm (Yanqihu), 2 GHz on 14 nm (Nanhu, 2023 tape-out) |
XiangShan एक ओपन-सोर्स, उच्च-प्रदर्शन RISC-V प्रोसेसर है जो 64-बिट निर्देश सेट आर्किटेक्चर को लागू करता है। इसके कोर आउट-ऑफ-ऑर्डर निष्पादन का उपयोग करते हैं, जिससे निर्देशों को उनके मूल प्रोग्राम अनुक्रम से भिन्न क्रम में संसाधित किया जा सकता है। यह दृष्टिकोण प्रोसेसर को निर्देश-स्तरीय समानांतरवाद का लाभ उठाने में सक्षम बनाता है, जिसमें स्वतंत्र संक्रियाएँ निष्पादित की जाती हैं जबकि अन्य निर्देश अपनी निर्भरताओं के समाधान की प्रतीक्षा कर रहे होते हैं। हार्डवेयर को Chisel में वर्णित किया गया है, जो Scala पर निर्मित एक हार्डवेयर निर्माण भाषा है, और इसे Mulan Permissive Software License, Version 2 के अंतर्गत वितरित किया जाता है।
नाम चीनी में Fragrant Hills के लिए है, जो पश्चिमी बीजिंग में एक पार्क है, और डिजाइन की प्रत्येक पीढ़ी एक झील का नाम लेती है। पहली पीढ़ी, Yanqihu, 2021 में 28 नैनोमीटर प्रक्रिया पर टेप आउट की गई और 1.3 GHz पर चलती थी, 5.3 CoreMark/MHz प्राप्त करते हुए। टेप आउट का मतलब है तैयार डिजाइन को निर्माण के लिए फैक्टरी में भेजना। Nanhu दूसरी पीढ़ी है, 2023 में 14 nm पर 2 GHz पर टेप आउट की गई, RV64GCBK के साथ। Kunminghu, तीसरी, सक्रिय विकास में है।
माइक्रोआर्किटेक्चर

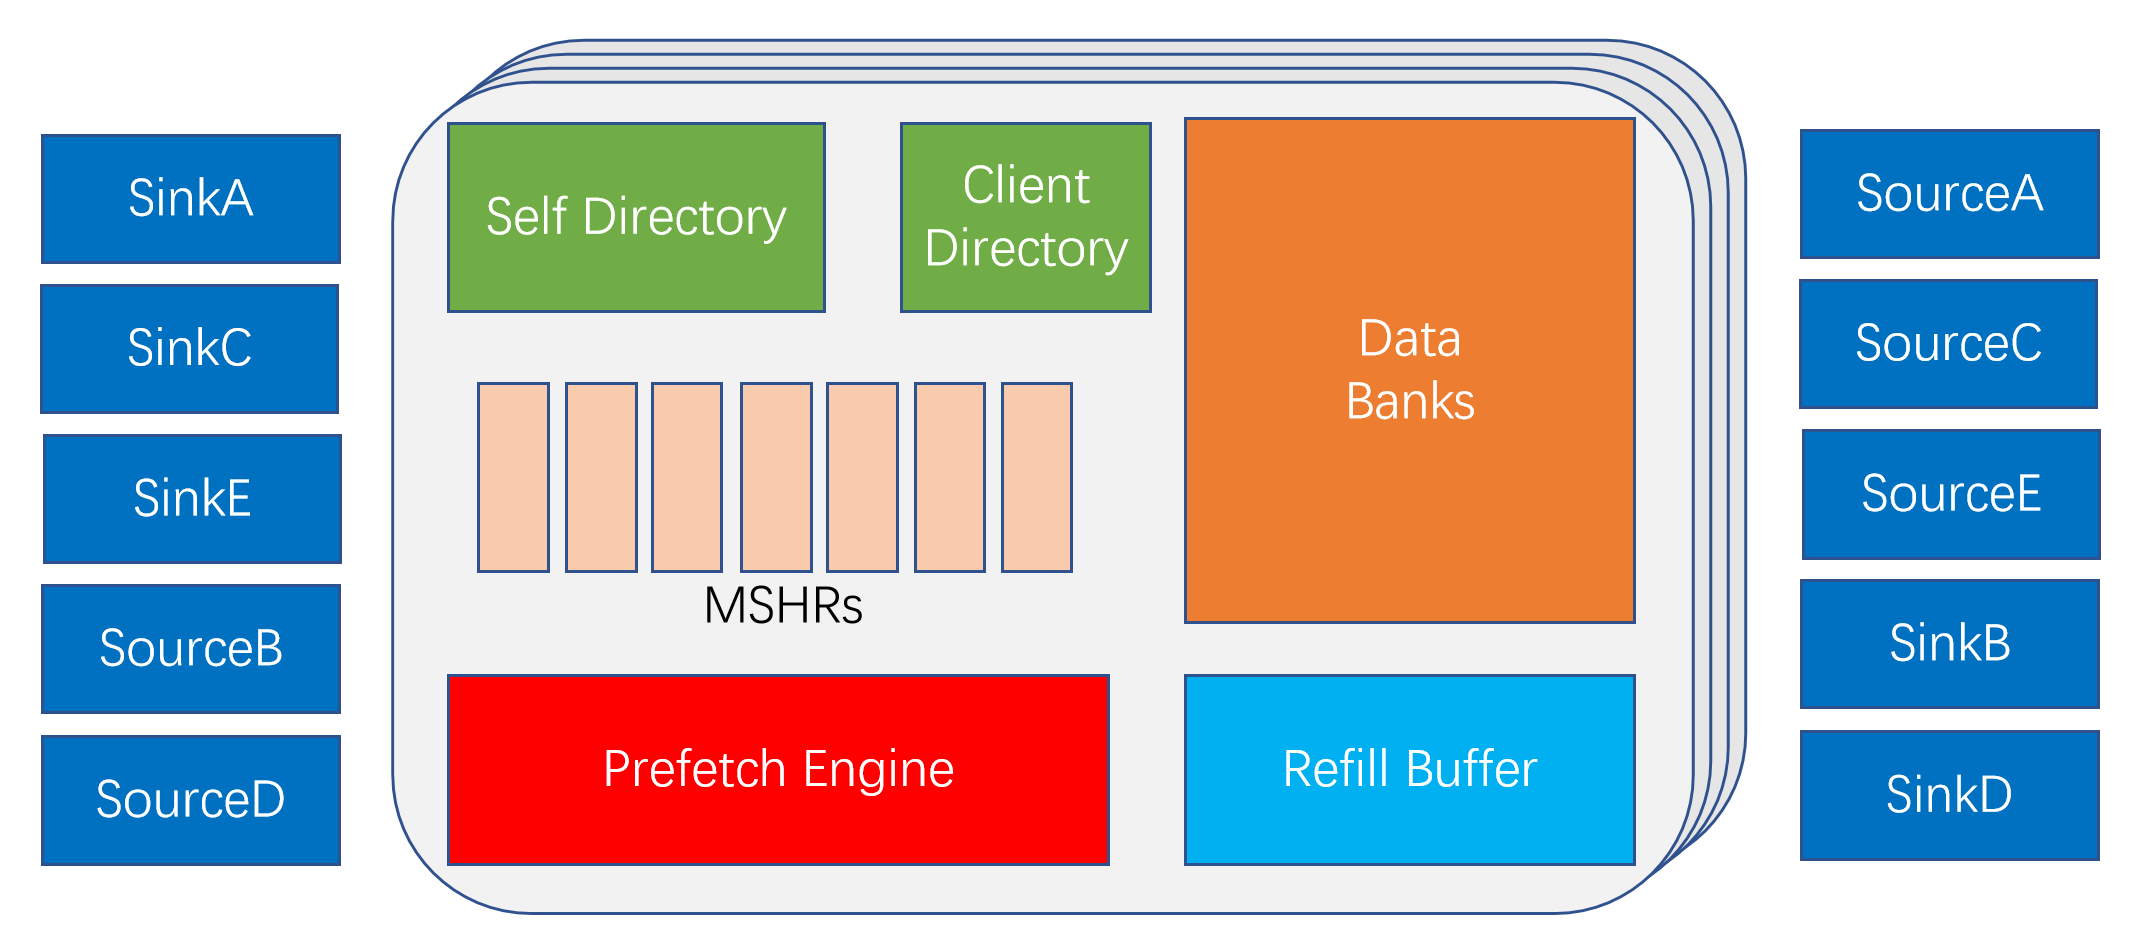
XiangShan एक आउट-ऑफ-ऑर्डर, मल्टी-इश्यू आर्किटेक्चर का उपयोग करता है, जिससे कई निर्देशों को एक साथ प्रेषित और निष्पादित किया जा सकता है, जबकि प्रोग्राम-दृश्यमान निष्पादन क्रम सही बना रहता है। Nanhu पीढ़ी में, मेमोरी सबसिस्टम में दो लोड पाइपलाइन, दो स्टोर एड्रेस पाइपलाइन और दो स्टोर डेटा पाइपलाइन शामिल हैं। इसका डेटा कैश प्रति चक्र दो 64-बिट पढ़ने की संक्रियाओं का समर्थन करता है, जो मेमोरी-गहन कार्यभार के लिए अतिरिक्त बैंडविड्थ प्रदान करता है। व्यक्तिगत कोर के ऊपर, Huancun एक साझा अंतिम-स्तरीय कैश प्रदान करता है, जिससे कई कोर एक सामान्य कैश पदानुक्रम तक पहुँच सकते हैं।
वर्चुअल मेमोरी एक्सेस को Translation Lookaside Buffer (TLB) के माध्यम से अनुवादित किया जाता है, जिसमें एक अतिरिक्त L2 TLB अधिक अनुवाद क्षमता प्रदान करता है। भौतिक मेमोरी एक्सेस अनुमतियों और विशेषताओं की जाँच Physical Memory Protection (PMP) और Physical Memory Attributes (PMA) तंत्रों के माध्यम से की जाती है। प्रोसेसर कोर और आसपास के सिस्टम के बीच संचार TileLink इंटरकनेक्ट प्रोटोकॉल के माध्यम से संभाला जाता है।
| भाग | यानकिहू | नानहू |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| निष्पादन | क्रम से बाहर, बहु-इश्यू | क्रम से बाहर, बहु-इश्यू |
| लोड पाइपलाइन्स | दो | दो |
| स्टोर पाइपलाइन्स | दो पता, दो डेटा | दो पता, दो डेटा |
| L1 डेटा कैश | दो 64-बिट रीड पोर्ट, एक लाइन-वाइड राइट पोर्ट | दो 64-बिट रीड पोर्ट, एक लाइन-वाइड राइट पोर्ट |
| अंतिम स्तर कैश | Huancun, साझा | Huancun, साझा |
| इंटरकनेक्ट | टाइललिंक | टाइललिंक |
मेमोरी और रजिस्टर मैप
XiangShan का डिफ़ॉल्ट भौतिक पता मानचित्र सिस्टम घटकों को विशिष्ट पता श्रेणियाँ आवंटित करता है, जिनमें मुख्य मेमोरी, परिधीय उपकरण और आरक्षित क्षेत्र शामिल हैं। Physical Memory Attributes (PMA) कॉन्फ़िगरेशन इन क्षेत्रों के लिए अनुमत एक्सेस गुणों को परिभाषित करता है, यह निर्धारित करते हुए कि प्रत्येक पता श्रेणी पर किस प्रकार की संक्रियाएँ की जा सकती हैं। जब सॉफ़्टवेयर परिभाषित क्षेत्रों के बाहर किसी पते तक पहुँचने का प्रयास करता है या संबंधित विशेषताओं द्वारा निषिद्ध कोई संक्रिया करता है, तो प्रोसेसर एक एक्सेस फॉल्ट उत्पन्न करता है। यह तंत्र हार्डवेयर को प्लेटफ़ॉर्म के भौतिक मेमोरी लेआउट और एक्सेस प्रतिबंधों को लागू करने की अनुमति देता है।
| क्षेत्र | पता सीमा |
|---|---|
| परिधीय स्थान | 0x0000_0000 से 0x7fff_ffff |
| DDR | 0x8000_0000 से 0xf_ffff_ffff |
| CLINT | 0x3800_0000 से 0x3800_ffff |
| बस त्रुटि इकाई | 0x3801_0000 से 0x3801_ffff |
| डीबग मॉड्यूल | 0x3802_0000 से 0x3802_0fff |
| L3 कैश नियंत्रण | 0x3900_0000 से 0x3900_0fff |
| PLIC | 0x3c00_0000 से 0x3fff_ffff |
Platform-Level Interrupt Controller (PLIC) बाहरी इंटरप्ट अनुरोधों को स्रोत 1-64 के माध्यम से प्राप्त करता है। स्रोत 65 और 66 क्रमशः कोर 0 और कोर 1 द्वारा उत्पन्न बस त्रुटि इंटरप्ट के लिए आरक्षित हैं।
भौतिक कार्यान्वयन
XiangShan ने प्रोटोटाइपिंग से आगे बढ़कर भौतिक सिलिकॉन कार्यान्वयन तक प्रगति की है। इसकी पहली पीढ़ी का डिजाइन, Yanqihu, 2021 में 28 nm निर्माण प्रक्रिया का उपयोग करके टेप आउट पूरा किया, रिपोर्ट की गई ऑपरेटिंग फ़्रीक्वेंसी 1.3 GHz और 5.3 CoreMark/MHz के साथ। दूसरी पीढ़ी, Nanhu, 2023 में 14 nm प्रक्रिया पर 2 GHz पर टेप आउट की गई। बाद की पीढ़ियों ने अधिक उन्नत सेमीकंडक्टर प्रक्रिया नोड्स और उच्च ऑपरेटिंग फ़्रीक्वेंसी का पीछा किया है, जो परियोजना के लगातार विकास को दर्शाता है, जो अधिक सक्षम प्रोसेसर कार्यान्वयनों की ओर अग्रसर है।
| पीढ़ी | रिपोर्ट किया गया आंकड़ा |
|---|---|
| यानकिहु | 28 nm, 1.3 GHz, 5.3 CoreMark/MHz, 2021 में टेप आउट |
| नानहु | 14 nm, 2 GHz, 2023 में टेप आउट |
| कुनमिंघु | लेखन के समय विकास में |
| FPGA | कोर के लिए कोई LUT संख्या प्रकाशित नहीं |
भाग की पहचान करना
XiangShan एक ओपन-सोर्स प्रोसेसर डिज़ाइन है जिसे विभिन्न SoC कार्यान्वयनों में एकीकृत किया जा सकता है। XiangShan-आधारित सिस्टम की पहचान करने के लिए सामान्य प्रोसेसर पहचानकर्ता पर निर्भर रहने के बजाय हार्डवेयर प्लेटफ़ॉर्म की जाँच करनी होती है। अंतर्निहित कार्यान्वयन की पहचान करने के लिए बोर्ड दस्तावेज़ीकरण, SoC विनिर्देशों या चिप अंकन से शुरुआत करें। यदि सिस्टम सुलभ है, तो प्रोसेसर जानकारी के लिए इसके बूट लॉग, डिवाइस ट्री और हार्डवेयर विवरण का निरीक्षण करें, जिसमें ISA, कोर संख्या, कैश कॉन्फ़िगरेशन और विक्रेता-विशिष्ट पहचानकर्ता शामिल हैं। रिपोर्ट किए गए mvendorid, marchid और mimpid CSR भी कार्यान्वयन की पहचान करने में सहायता कर सकते हैं, बशर्ते प्लेटफ़ॉर्म उनके लिए सार्थक मान प्रदान करता हो।
मेमोरी मानचित्र डिबग मॉड्यूल और कैश नियंत्रकों को निश्चित पतों पर रखता है, जो प्लेटफ़ॉर्म की पहचान करते हैं।
| जहाँ यह दिखाई देता है | कैसे पुष्टि करें |
|---|---|
| यानकिहू और नानहू बोर्ड | प्लेटफ़ॉर्म दस्तावेज़ीकरण और निश्चित परिधीय मैप |
| अनुसंधान प्रणालियाँ | प्रोजेक्ट पेपर और रिलीज़ नोट्स |
| सॉफ़्टवेयर इमेज | डिवाइस ट्री और डीबग मॉड्यूल का आधार पता |
डिसअसेम्बली और डीबगिंग
डिबग मॉड्यूल RISC-V External Debug Support 0.13.2 का अनुसरण करता है और परिधीय स्थान में एक निश्चित पते पर स्थित है। OpenOCD डिफ़ॉल्ट रूप से रिमोट बिटबैंग कनेक्शन के माध्यम से इससे जुड़ता है।
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| वस्तु | मूल्य |
|---|---|
| ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| कंपाइलर फ़्लैग | यानकिहू के लिए -march=rv64gc -mabi=lp64d; नानहू के लिए -march=rv64gcbk -mabi=lp64d, बिल्ड जो एक्सटेंशन सक्षम करता है उन्हें जोड़ें |
| डीबग मॉड्यूल | 0x3802_0000 से 0x3802_0fff, प्रोटोकॉल 0.13.2 |
| प्रोग्राम बफ़र | 16 बाइट्स, अमूर्त कमांड इसका उपयोग करते हैं |
| ट्रिगर | 10 मैच कंट्रोल ट्रिगर |
| misa (0x301) | ISA और सक्षम एक्सटेंशन |
| mvendorid (0xF11) | JEDEC विक्रेता ID, केवल-पढ़ने योग्य |
| marchid (0xF12) | माइक्रोआर्किटेक्चर ID, केवल-पढ़ने योग्य |
| mimpid (0xF13) | कार्यान्वयन संस्करण, केवल-पढ़ने योग्य |
| mhartid (0xF14) | वह hart जो कोड चलाता है, केवल-पढ़ने योग्य |
इतिहास
चीनी विज्ञान अकादमी के कंप्यूटिंग प्रौद्योगिकी संस्थान ने 2019 में XiangShan की शुरुआत की, और प्रथम पीढ़ी पर कार्य जून 2020 में शुरू हुआ। पेंग चेंग प्रयोगशाला ने भौतिक डिज़ाइन का अधिकांश कार्य किया, जो तर्क को ऐसे लेआउट में बदलने का चरण है जिसे कोई कारखाना उत्पादित कर सके।
टीम ने MICRO 2022 में अपनी विकास विधियाँ प्रस्तुत कीं, जो एक प्रमुख कंप्यूटर आर्किटेक्चर सम्मेलन है। उद्योग भागीदारों के साथ स्थापित एक गैर-लाभकारी संस्था, बीजिंग इंस्टीट्यूट ऑफ ओपन सोर्स चिप, अब विकास का समन्वय करती है।
इसका उपयोग कहाँ होता है
XiangShan का लक्ष्य वाणिज्यिक एप्लिकेशन प्रोसेसरों का प्रदर्शन है, जो फ़ोन और सर्वर में पाए जाते हैं। शोधकर्ता इसका उपयोग उच्च-स्तरीय प्रोसेसर डिज़ाइन के अध्ययन के लिए करते हैं, और परियोजना कोर के साथ-साथ अपने सिमुलेशन, सत्यापन और प्रदर्शन विश्लेषण उपकरण प्रकाशित करती है।