XiangShan
Écosystème RISC-VXiangShan est un cœur RV64 hors ordre haute performance écrit en Chisel, démarré en 2019 à l'Institut de technologie informatique de l'Académie chinoise des sciences. Ses générations portent des noms de lacs, de Yanqihu, dont la fabrication a été finalisée en 2021, à Nanhu et Kunminghu.
Aperçu
| Spécification | Valeur |
|---|---|
| Prise en charge d'ISA | Yanqihu : RV64GC, Nanhu : RV64GCBK |
| Microarchitecture | Exécution dans le désordre, multi-émission ; les générations sont Yanqihu, Nanhu et Kunminghu |
| Densité de performance | 5,3 CoreMark/MHz à 1,3 GHz (Yanqihu) |
| Empreinte en ressources | Orienté ASIC ; le projet ne publie aucun nombre de LUT FPGA |
| Domaine d'horloge | 1,3 GHz en 28 nm (Yanqihu), 2 GHz en 14 nm (Nanhu, tape-out 2023) |
XiangShan est un processeur RISC-V open source hautes performances mettant en œuvre l'architecture du jeu d'instructions 64 bits. Ses cœurs emploient l'exécution dans le désordre, ce qui permet de traiter les instructions dans un ordre différent de leur séquence d'origine dans le programme. Cette approche permet au processeur d'exploiter le parallélisme au niveau des instructions en exécutant des opérations indépendantes pendant que d'autres instructions attendent la résolution de leurs dépendances. Le matériel est décrit en Chisel, un langage de construction matérielle bâti sur Scala, et distribué sous la licence Mulan Permissive Software License, version 2.
Le nom est le terme chinois désignant les Collines Parfumées, un parc de l'ouest de Pékin, et chaque génération de conception reprend le nom d'un lac. La première génération, Yanqihu, a été finalisée en 2021 sur un procédé de 28 nanomètres et fonctionnait à 1,3 GHz, atteignant 5,3 CoreMark/MHz. Finaliser (tape-out) signifie envoyer une conception achevée à une usine pour fabrication. Nanhu est la deuxième génération, finalisée en 2023 sur 14 nm à 2 GHz avec RV64GCBK. Kunminghu, la troisième, est en développement actif.
Microarchitecture

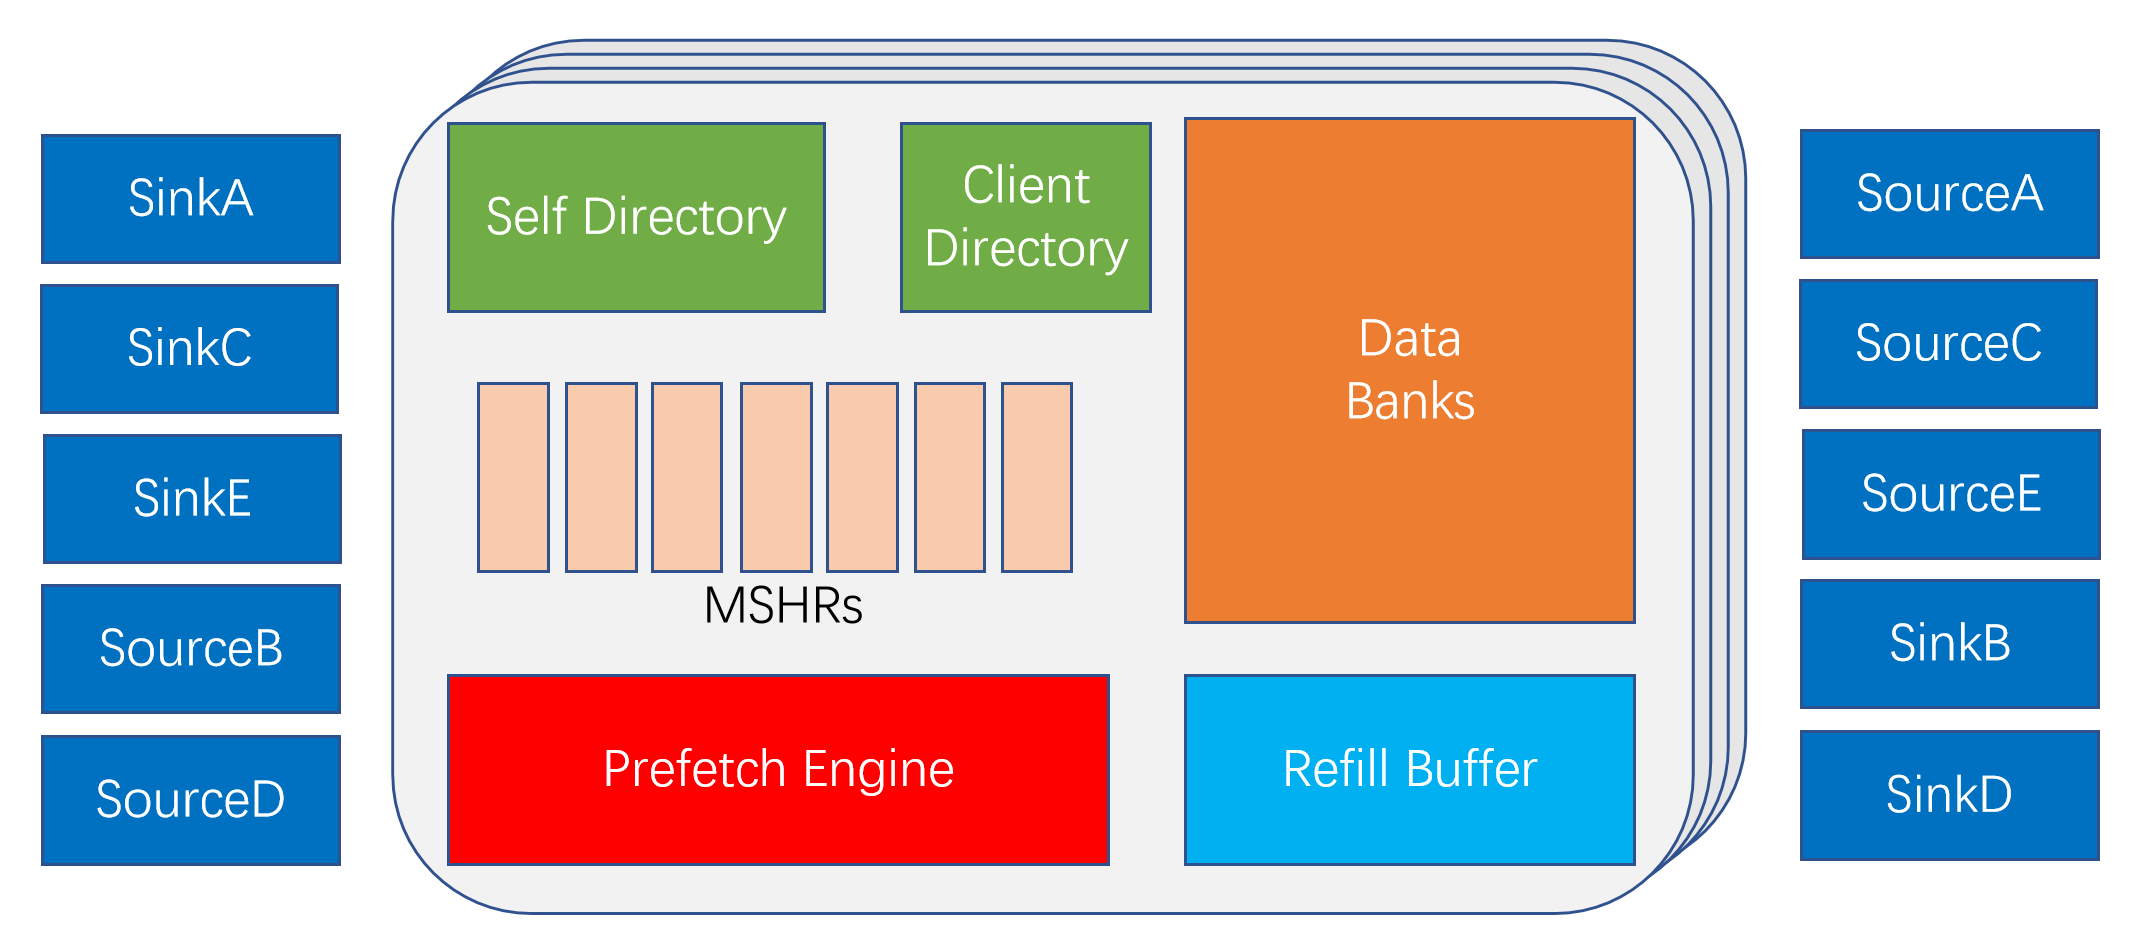
XiangShan emploie une architecture dans le désordre à émission multiple, permettant à plusieurs instructions d'être distribuées et exécutées simultanément tout en conservant l'ordre d'exécution correct visible par le programme. Dans la génération Nanhu, le sous-système mémoire comprend deux pipelines de chargement, deux pipelines d'adresse de stockage et deux pipelines de données de stockage. Son cache de données prend en charge deux opérations de lecture 64 bits par cycle, offrant une bande passante supplémentaire pour les charges de travail gourmandes en mémoire. Au-dessus des cœurs individuels, Huancun fournit un cache de dernier niveau partagé, permettant à plusieurs cœurs d'accéder à une hiérarchie de caches commune.
Les accès à la mémoire virtuelle sont traduits via un Translation Lookaside Buffer (TLB), avec un TLB L2 supplémentaire offrant une capacité de traduction accrue. Les permissions et attributs d'accès à la mémoire physique sont vérifiés via les mécanismes Physical Memory Protection (PMP) et Physical Memory Attributes (PMA). La communication entre les cœurs du processeur et le système environnant est gérée par le protocole d'interconnexion TileLink.
| Partie | Yanqihu | Nanhu |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| Exécution | Désordonnée, multi-émission | Désordonnée, multi-émission |
| Pipelines de chargement | Deux | Deux |
| Pipelines de stockage | Deux adresses, deux données | Deux adresses, deux données |
| Cache de données L1 | Deux ports de lecture 64 bits, un port d'écriture de la largeur d'une ligne | Deux ports de lecture 64 bits, un port d'écriture de la largeur d'une ligne |
| Cache de dernier niveau | Huancun, partagé | Huancun, partagé |
| Interconnexion | TileLink | TileLink |
Carte mémoire et registres
La carte d'adresses physiques par défaut de XiangShan attribue des plages d'adresses spécifiques aux composants du système, notamment la mémoire principale, les périphériques et les régions réservées. La configuration Physical Memory Attributes (PMA) définit les propriétés d'accès autorisées pour ces régions, déterminant quels types d'opérations peuvent être effectués dans chaque plage d'adresses. Lorsqu'un logiciel tente d'accéder à une adresse hors des régions définies ou effectue une opération interdite par les attributs correspondants, le processeur lève une faute d'accès. Ce mécanisme permet au matériel d'imposer la disposition de la mémoire physique et les restrictions d'accès de la plateforme.
| Région | Plage d'adresses |
|---|---|
| Espace périphérique | 0x0000_0000 à 0x7fff_ffff |
| DDR | 0x8000_0000 à 0xf_ffff_ffff |
| CLINT | 0x3800_0000 à 0x3800_ffff |
| Unité d'erreur de bus | 0x3801_0000 à 0x3801_ffff |
| Module de débogage | 0x3802_0000 à 0x3802_0fff |
| Contrôle du cache L3 | 0x3900_0000 à 0x3900_0fff |
| PLIC | 0x3c00_0000 à 0x3fff_ffff |
Le contrôleur d'interruptions au niveau de la plateforme (PLIC) reçoit les demandes d'interruption externes via les sources 1 à 64. Les sources 65 et 66 sont réservées aux interruptions d'erreur de bus générées respectivement par le cœur 0 et le cœur 1.
Implémentation physique
XiangShan a dépassé le stade du prototypage pour aboutir à une implémentation physique en silicium. Sa conception de première génération, Yanqihu, a achevé sa finalisation en 2021 selon un procédé de fabrication de 28 nm, avec une fréquence de fonctionnement annoncée de 1,3 GHz et 5,3 CoreMark/MHz. La deuxième génération, Nanhu, a été finalisée en 2023 sur un procédé de 14 nm à 2 GHz. Les générations suivantes ont visé des nœuds de procédé semi-conducteur plus avancés et des fréquences de fonctionnement plus élevées, ce qui reflète la poursuite du développement du projet vers des implémentations de processeurs toujours plus performantes.
| Génération | Chiffre rapporté |
|---|---|
| Yanqihu | 28 nm, 1.3 GHz, 5.3 CoreMark/MHz, tape-out en 2021 |
| Nanhu | 14 nm, 2 GHz, tape-out en 2023 |
| Kunminghu | En développement au moment de la rédaction |
| FPGA | Aucun nombre de LUT publié pour le cœur |
Identification du composant
XiangShan est une conception de processeur open source qui peut être intégrée dans différentes implémentations de SoC. Identifier un système basé sur XiangShan nécessite d'examiner la plateforme matérielle plutôt que de se fier à un identifiant de processeur générique. Commencez par la documentation de la carte, les spécifications du SoC ou les marquages de la puce pour identifier l'implémentation sous-jacente. Si le système est accessible, inspectez ses journaux de démarrage, son arborescence de périphériques et sa description matérielle pour obtenir des informations sur le processeur, notamment l'ISA, le nombre de cœurs, la configuration des caches et les identifiants propres au fournisseur. Les CSRs mvendorid, marchid et mimpid rapportés peuvent également aider à identifier l'implémentation, à condition que la plateforme expose des valeurs significatives pour ceux-ci.
La carte mémoire place le module de débogage et les contrôleurs de cache à des adresses fixes, ce qui identifie la plateforme.
| Où cela apparaît | Comment confirmer |
|---|---|
| Cartes Yanqihu et Nanhu | Documentation de la plateforme et carte des périphériques fixe |
| Systèmes de recherche | Articles du projet et notes de version |
| Images logicielles | Arborescence de périphériques et adresse de base du module de débogage |
Désassemblage et débogage
Le module de débogage suit la spécification RISC-V External Debug Support 0.13.2 et occupe une adresse fixe dans l'espace des périphériques. OpenOCD s'y connecte par défaut via une connexion remote bitbang.
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| Élément | Valeur |
|---|---|
| ISA | Yanqihu : RV64GC, Nanhu : RV64GCBK |
| Options du compilateur | -march=rv64gc -mabi=lp64d pour Yanqihu; -march=rv64gcbk -mabi=lp64d pour Nanhu, ajouter les extensions que la construction active |
| Module de débogage | 0x3802_0000 à 0x3802_0fff, protocole 0.13.2 |
| Tampon de programme | 16 octets, les commandes abstraites l'utilisent |
| Déclencheurs | 10 déclencheurs de contrôle de correspondance |
| misa (0x301) | ISA et extensions activées |
| mvendorid (0xF11) | ID de fournisseur JEDEC, en lecture seule |
| marchid (0xF12) | ID de microarchitecture, en lecture seule |
| mimpid (0xF13) | version d'implémentation, en lecture seule |
| mhartid (0xF14) | hart qui exécute le code, en lecture seule |
Historique
L'Institut de technologie informatique de l'Académie chinoise des sciences a lancé XiangShan en 2019, et les travaux sur la première génération ont commencé en juin 2020. Le Peng Cheng Laboratory a réalisé une grande partie de la conception physique, l'étape qui transforme la logique en une disposition qu'une usine peut produire.
L'équipe a présenté ses méthodes de développement à MICRO 2022, une conférence majeure sur l'architecture des ordinateurs. Le Beijing Institute of Open Source Chip, une organisation à but non lucratif fondée avec des partenaires industriels, coordonne désormais le développement.
Où il est utilisé
XiangShan vise les performances des processeurs d'application commerciaux, du type de ceux que l'on trouve dans les téléphones et les serveurs. Les chercheurs l'utilisent pour étudier la conception de processeurs haut de gamme, et le projet publie ses outils de simulation, de vérification et d'analyse de performances aux côtés du cœur.