XiangShan
Ecossistema RISC-VXiangShan é um núcleo RV64 fora de ordem de alto desempenho escrito em Chisel, iniciado em 2019 no Instituto de Tecnologia da Computação da Academia Chinesa de Ciências. Suas gerações recebem nomes de lagos, de Yanqihu, com tape-out em 2021, a Nanhu e Kunminghu.
Visão geral
| Especificação | Valor |
|---|---|
| Suporte a ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Microarquitetura | Fora de ordem, múltiplas emissões; as gerações são Yanqihu, Nanhu e Kunminghu |
| Densidade de desempenho | 5,3 CoreMark/MHz a 1,3 GHz (Yanqihu) |
| Consumo de recursos | Orientado a ASIC; o projeto não publica contagem de LUT de FPGA |
| Domínio de clock | 1,3 GHz em 28 nm (Yanqihu), 2 GHz em 14 nm (Nanhu, tape-out de 2023) |
XiangShan é um processador RISC-V de código aberto e alto desempenho que implementa a arquitetura de conjunto de instruções de 64 bits. Seus núcleos empregam execução fora de ordem, permitindo que as instruções sejam processadas em uma ordem diferente da sequência original do programa. Essa abordagem permite que o processador explore o paralelismo em nível de instrução executando operações independentes enquanto outras instruções aguardam a resolução de suas dependências. O hardware é descrito em Chisel, uma linguagem de construção de hardware baseada em Scala, e distribuído sob a Mulan Permissive Software License, Versão 2.
O nome é o termo chinês para Colinas Fragrantes, um parque no oeste de Pequim, e cada geração do design recebe o nome de um lago. A primeira geração, Yanqihu, foi finalizada em 2021 em um processo de 28 nanômetros e operava a 1,3 GHz, alcançando 5,3 CoreMark/MHz. Finalizar (tape-out) significa enviar um design concluído a uma fábrica para fabricação. Nanhu é a segunda geração, finalizada em 2023 em 14 nm a 2 GHz com RV64GCBK. Kunminghu, a terceira, está em desenvolvimento ativo.
Microarquitetura

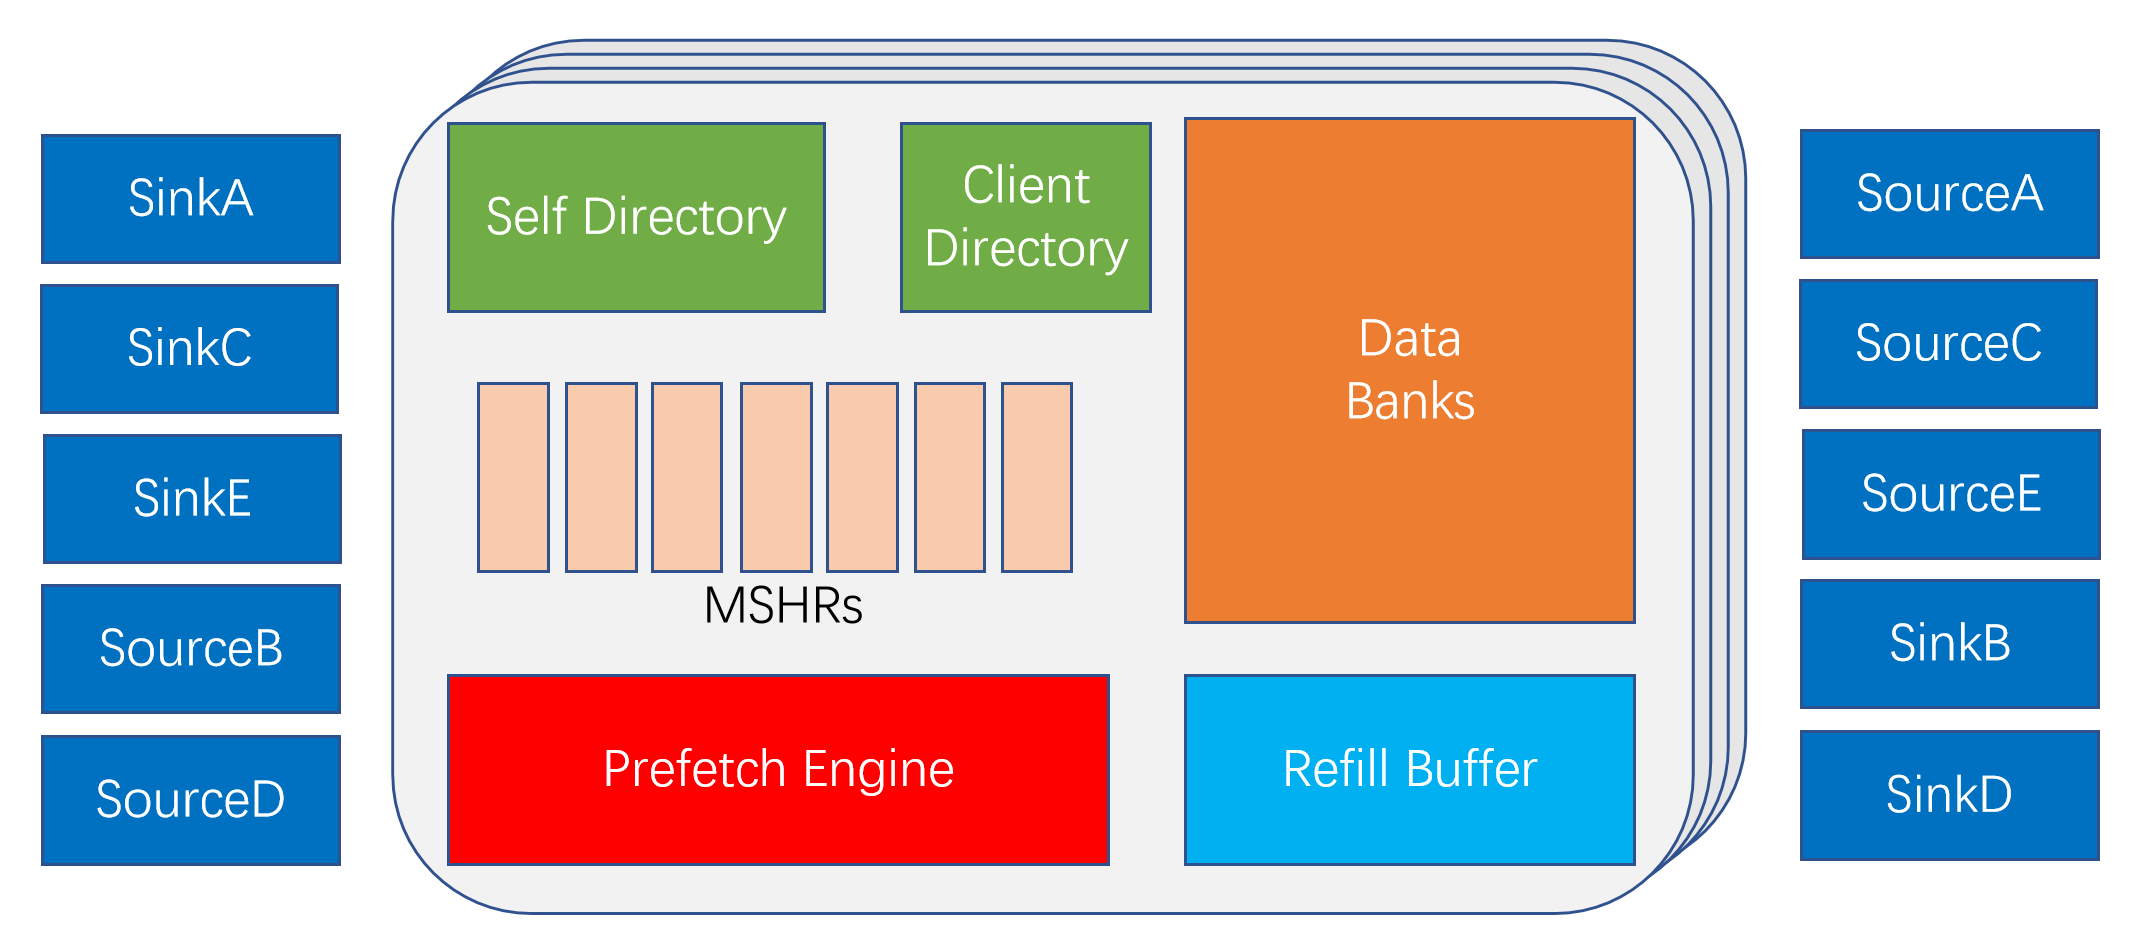
XiangShan emprega uma arquitetura fora de ordem e de múltiplas emissões, permitindo que várias instruções sejam despachadas e executadas simultaneamente enquanto mantém a ordem de execução correta visível ao programa. Na geração Nanhu, o subsistema de memória inclui dois pipelines de carga, dois pipelines de endereço de armazenamento e dois pipelines de dados de armazenamento. Seu cache de dados suporta duas operações de leitura de 64 bits por ciclo, fornecendo largura de banda adicional para cargas de trabalho intensivas em memória. Acima dos núcleos individuais, Huancun fornece um cache de último nível compartilhado, permitindo que vários núcleos acessem uma hierarquia de cache comum.
Os acessos à memória virtual são traduzidos por meio de um Translation Lookaside Buffer (TLB), com um TLB L2 adicional fornecendo capacidade de tradução extra. As permissões e atributos de acesso à memória física são verificados por meio dos mecanismos Physical Memory Protection (PMP) e Physical Memory Attributes (PMA). A comunicação entre os núcleos do processador e o sistema ao redor é tratada pelo protocolo de interconexão TileLink.
| Parte | Yanqihu | Nanhu |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| Execução | Fora de ordem, múltiplas emissões | Fora de ordem, múltiplas emissões |
| Pipelines de carga | Dois | Dois |
| Pipelines de armazenamento | Dois de endereço, dois de dados | Dois de endereço, dois de dados |
| Cache de dados L1 | Duas portas de leitura de 64 bits, uma porta de escrita da largura de uma linha | Duas portas de leitura de 64 bits, uma porta de escrita da largura de uma linha |
| Cache de último nível | Huancun, compartilhado | Huancun, compartilhado |
| Interconexão | TileLink | TileLink |
Mapa de memória e registradores
O mapa de endereços físicos padrão do XiangShan atribui faixas de endereço específicas aos componentes do sistema, incluindo memória principal, dispositivos periféricos e regiões reservadas. A configuração Physical Memory Attributes (PMA) define as propriedades de acesso permitidas para essas regiões, determinando quais tipos de operações podem ser realizados em cada faixa de endereço. Quando o software tenta acessar um endereço fora das regiões definidas ou realiza uma operação proibida pelos atributos correspondentes, o processador gera uma falha de acesso. Esse mecanismo permite que o hardware imponha o layout de memória física e as restrições de acesso da plataforma.
| Região | Intervalo de endereços |
|---|---|
| Espaço periférico | 0x0000_0000 a 0x7fff_ffff |
| DDR | 0x8000_0000 a 0xf_ffff_ffff |
| CLINT | 0x3800_0000 a 0x3800_ffff |
| Unidade de erro de barramento | 0x3801_0000 a 0x3801_ffff |
| Módulo de depuração | 0x3802_0000 a 0x3802_0fff |
| Controle de cache L3 | 0x3900_0000 a 0x3900_0fff |
| PLIC | 0x3c00_0000 a 0x3fff_ffff |
O Controlador de Interrupções em Nível de Plataforma (PLIC) recebe solicitações de interrupção externas por meio das fontes 1 a 64. As fontes 65 e 66 são reservadas para interrupções de erro de barramento geradas pelo núcleo 0 e pelo núcleo 1, respectivamente.
Implementação física
O XiangShan avançou além da prototipagem para a implementação física em silício. Seu design de primeira geração, Yanqihu, concluiu a finalização em 2021 usando um processo de fabricação de 28 nm, com frequência de operação relatada de 1,3 GHz e 5,3 CoreMark/MHz. A segunda geração, Nanhu, foi finalizada em 2023 em um processo de 14 nm a 2 GHz. As gerações seguintes buscaram nós de processo semicondutor mais avançados e frequências de operação mais altas, refletindo o desenvolvimento contínuo do projeto rumo a implementações de processadores cada vez mais capazes.
| Geração | Número relatado |
|---|---|
| Yanqihu | 28 nm, 1.3 GHz, 5.3 CoreMark/MHz, finalizado em 2021 |
| Nanhu | 14 nm, 2 GHz, finalizado em 2023 |
| Kunminghu | Em desenvolvimento no momento da escrita |
| FPGA | Nenhuma contagem de LUT publicada para o núcleo |
Identificação da peça
XiangShan é um projeto de processador de código aberto que pode ser integrado a diferentes implementações de SoC. Identificar um sistema baseado em XiangShan exige examinar a plataforma de hardware em vez de confiar em um identificador genérico de processador. Comece pela documentação da placa, pelas especificações do SoC ou pelas marcações do chip para identificar a implementação subjacente. Se o sistema estiver acessível, inspecione seus logs de inicialização, a árvore de dispositivos e a descrição de hardware em busca de informações do processador, incluindo a ISA, a contagem de núcleos, a configuração de cache e identificadores específicos do fornecedor. Os CSRs mvendorid, marchid e mimpid relatados também podem ajudar a identificar a implementação, desde que a plataforma exponha valores significativos para eles.
O mapa de memória coloca o módulo de depuração e os controladores de cache em endereços fixos, o que identifica a plataforma.
| Onde aparece | Como confirmar |
|---|---|
| Placas Yanqihu e Nanhu | Documentação da plataforma e mapa fixo de periféricos |
| Sistemas de pesquisa | Artigos do projeto e notas de versão |
| Imagens de software | Árvore de dispositivos e endereço base do módulo de depuração |
Desmontagem e depuração
O módulo de depuração segue o RISC-V External Debug Support 0.13.2 e fica em um endereço fixo no espaço de periféricos. O OpenOCD se conecta a ele por meio de uma conexão remote bitbang por padrão.
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| Item | Valor |
|---|---|
| ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Sinalizadores do compilador | -march=rv64gc -mabi=lp64d for Yanqihu; -march=rv64gcbk -mabi=lp64d for Nanhu, adicionar extensões que a compilação habilita |
| Módulo de depuração | 0x3802_0000 a 0x3802_0fff, protocolo 0.13.2 |
| Buffer de programa | 16 bytes, os comandos abstratos o utilizam |
| Gatilhos | 10 gatilhos de controle de correspondência |
| misa (0x301) | ISA e extensões habilitadas |
| mvendorid (0xF11) | ID de fornecedor JEDEC, somente leitura |
| marchid (0xF12) | ID de microarquitetura, somente leitura |
| mimpid (0xF13) | versão de implementação, somente leitura |
| mhartid (0xF14) | hart que executa o código, somente leitura |
Histórico
O Instituto de Tecnologia da Computação da Academia Chinesa de Ciências iniciou o XiangShan em 2019, e o trabalho na primeira geração começou em junho de 2020. O Peng Cheng Laboratory realizou grande parte do projeto físico, a etapa que transforma a lógica em um layout que uma fábrica pode produzir.
A equipe apresentou seus métodos de desenvolvimento na MICRO 2022, uma importante conferência de arquitetura de computadores. O Beijing Institute of Open Source Chip, uma organização sem fins lucrativos fundada com parceiros da indústria, agora coordena o desenvolvimento.
Onde é usado
XiangShan tem como objetivo o desempenho de processadores de aplicação comerciais, do tipo encontrado em telefones e servidores. Pesquisadores o utilizam para estudar o projeto de processadores de alto nível, e o projeto publica suas ferramentas de simulação, verificação e análise de desempenho junto com o núcleo.