XiangShan
Ekosystem RISC-VXiangShan to wysokowydajny rdzeń RV64 z wykonaniem poza kolejnością, napisany w Chisel, zapoczątkowany w 2019 roku w Instytucie Technologii Obliczeniowej Chińskiej Akademii Nauk. Jego kolejne generacje noszą nazwy jezior, od Yanqihu, wyprodukowanego w 2021 roku, po Nanhu i Kunminghu.
Przegląd
| Specyfikacja | Wartość |
|---|---|
| Obsługa ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Mikroarchitektura | Wykonywanie poza kolejnością, wielokrotne wydawanie; generacje to Yanqihu, Nanhu i Kunminghu |
| Gęstość wydajności | 5.3 CoreMark/MHz przy 1.3 GHz (Yanqihu) |
| Zużycie zasobów | Zorientowany na ASIC; projekt nie publikuje liczby LUT dla FPGA |
| Domena zegara | 1.3 GHz w 28 nm (Yanqihu), 2 GHz w 14 nm (Nanhu, tape-out 2023) |
XiangShan to otwartoźródłowy procesor RISC-V o wysokiej wydajności, implementujący 64-bitową architekturę zestawu instrukcji. Jego rdzenie wykorzystują wykonanie poza kolejnością, co pozwala przetwarzać instrukcje w kolejności innej niż ich pierwotna sekwencja w programie. Takie podejście umożliwia procesorowi wykorzystanie równoległości na poziomie instrukcji poprzez wykonywanie niezależnych operacji, podczas gdy inne instrukcje czekają na rozwiązanie swoich zależności. Sprzęt jest opisany w Chisel, języku konstruowania sprzętu zbudowanym na Scali, i rozpowszechniany na licencji Mulan Permissive Software License, Version 2.
Nazwa jest chińskim określeniem Fragrant Hills, parku w zachodnim Pekinie, a każde pokolenie projektu przyjmuje nazwę jeziora. Pierwsza generacja, Yanqihu, została oddana do produkcji (tape-out) w 2021 roku w procesie 28 nanometrów i działała z częstotliwością 1,3 GHz, osiągając 5,3 CoreMark/MHz. Tape-out oznacza wysłanie gotowego projektu do fabryki w celu produkcji. Nanhu to druga generacja, oddana do produkcji w 2023 roku w procesie 14 nm z częstotliwością 2 GHz z RV64GCBK. Kunminghu, trzecia, jest w aktywnym rozwoju.
Mikroarchitektura

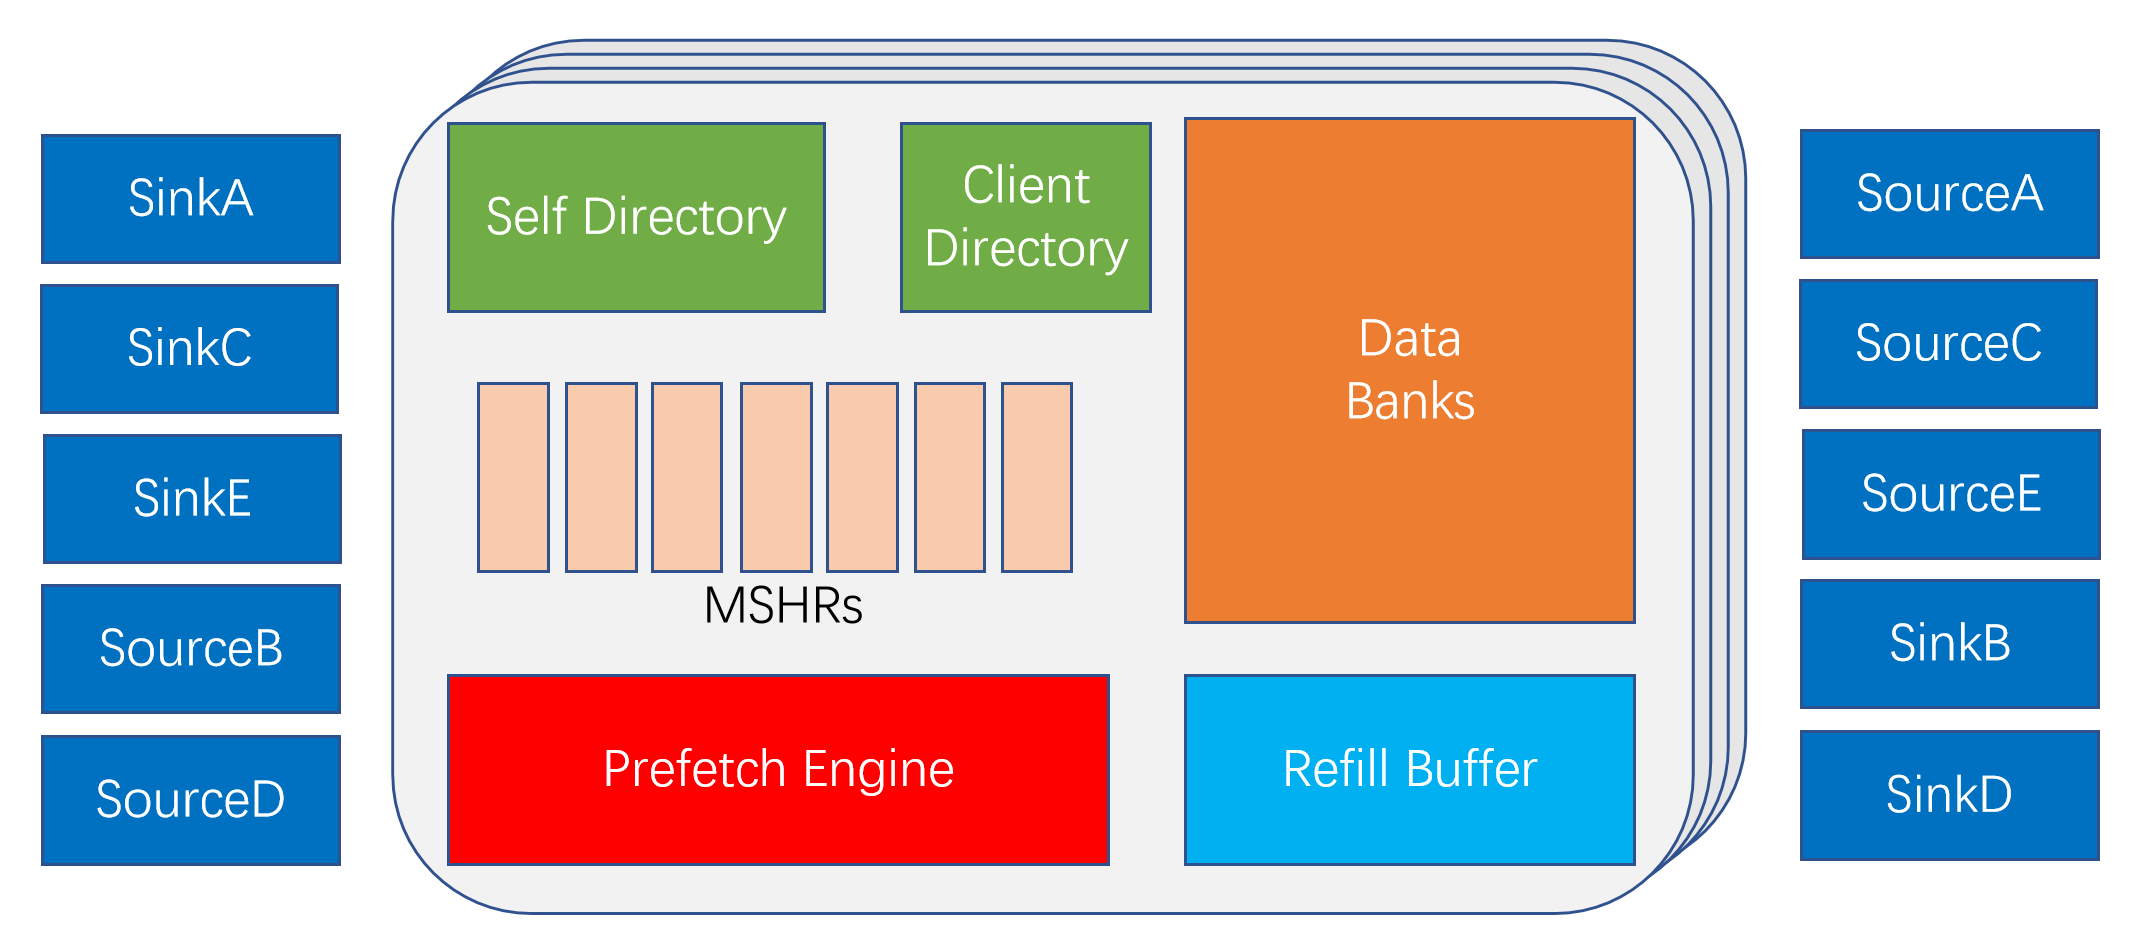
XiangShan stosuje architekturę poza kolejnością z wielokrotnym wydawaniem, co pozwala na jednoczesne wysyłanie i wykonywanie wielu instrukcji przy zachowaniu prawidłowej kolejności wykonania widocznej dla programu. W generacji Nanhu podsystem pamięci obejmuje dwa potoki ładowania, dwa potoki adresów zapisu i dwa potoki danych zapisu. Jego pamięć podręczna danych obsługuje dwie 64-bitowe operacje odczytu na cykl, zapewniając dodatkową przepustowość dla obciążeń intensywnie korzystających z pamięci. Ponad poszczególnymi rdzeniami Huancun zapewnia współdzieloną pamięć podręczną ostatniego poziomu, umożliwiając wielu rdzeniom dostęp do wspólnej hierarchii pamięci podręcznej.
Dostępy do pamięci wirtualnej są tłumaczone przez Translation Lookaside Buffer (TLB), a dodatkowy TLB L2 zapewnia większą pojemność tłumaczenia. Uprawnienia i atrybuty dostępu do pamięci fizycznej są sprawdzane przez mechanizmy Physical Memory Protection (PMP) i Physical Memory Attributes (PMA). Komunikacja między rdzeniami procesora a otaczającym systemem jest obsługiwana przez protokół połączeń TileLink.
| Część | Yanqihu | Nanhu |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| Wykonywanie | Poza kolejnością, wielokrotne wydawanie | Poza kolejnością, wielokrotne wydawanie |
| Potoki wczytywania | Dwa | Dwa |
| Potoki zapisywania | Dwa adresowe, dwa danych | Dwa adresowe, dwa danych |
| Pamięć podręczna danych L1 | Dwa 64-bitowe porty odczytu, jeden port zapisu o szerokości linii | Dwa 64-bitowe porty odczytu, jeden port zapisu o szerokości linii |
| Pamięć podręczna ostatniego poziomu | Huancun, współdzielona | Huancun, współdzielona |
| Interconnect | TileLink | TileLink |
Mapa pamięci i rejestrów
Domyślna mapa adresów fizycznych XiangShan przypisuje określone zakresy adresów składnikom systemu, w tym pamięci głównej, urządzeniom peryferyjnym i regionom zarezerwowanym. Konfiguracja Physical Memory Attributes (PMA) definiuje dozwolone właściwości dostępu dla tych regionów, określając, jakie typy operacji można wykonywać w każdym zakresie adresów. Gdy oprogramowanie próbuje uzyskać dostęp do adresu spoza zdefiniowanych regionów lub wykonuje operację zabronioną przez odpowiednie atrybuty, procesor zgłasza błąd dostępu. Mechanizm ten pozwala sprzętowi egzekwować układ pamięci fizycznej platformy i ograniczenia dostępu.
| Region | Zakres adresów |
|---|---|
| Przestrzeń peryferyjna | 0x0000_0000 do 0x7fff_ffff |
| DDR | 0x8000_0000 do 0xf_ffff_ffff |
| CLINT | 0x3800_0000 do 0x3800_ffff |
| Jednostka błędu magistrali | 0x3801_0000 do 0x3801_ffff |
| Moduł debugowania | 0x3802_0000 do 0x3802_0fff |
| Sterowanie pamięcią podręczną L3 | 0x3900_0000 do 0x3900_0fff |
| PLIC | 0x3c00_0000 do 0x3fff_ffff |
Kontroler przerwań na poziomie platformy (PLIC) odbiera zewnętrzne żądania przerwań przez źródła 1-64. Źródła 65 i 66 są zarezerwowane odpowiednio dla przerwań błędu magistrali generowanych przez rdzeń 0 i rdzeń 1.
Implementacja fizyczna
XiangShan wyszedł poza fazę prototypowania i wszedł w fizyczną implementację krzemową. Jego pierwsza generacja, Yanqihu, zakończyła tape-out w 2021 roku z wykorzystaniem procesu produkcyjnego 28 nm, z raportowaną częstotliwością pracy 1,3 GHz i wynikiem 5,3 CoreMark/MHz. Druga generacja, Nanhu, została oddana do produkcji w 2023 roku w procesie 14 nm z częstotliwością 2 GHz. Kolejne generacje dążyły do bardziej zaawansowanych węzłów procesowych półprzewodników i wyższych częstotliwości pracy, co odzwierciedla ciągły rozwój projektu w kierunku coraz wydajniejszych implementacji procesorów.
| Generacja | Zgłoszona liczba |
|---|---|
| Yanqihu | 28 nm, 1,3 GHz, 5,3 CoreMark/MHz, taśma wyprodukowana w 2021 |
| Nanhu | 14 nm, 2 GHz, taśma wyprodukowana w 2023 |
| Kunminghu | W opracowaniu w chwili pisania |
| FPGA | Nie opublikowano liczby LUT dla rdzenia |
Identyfikacja części
XiangShan to otwartoźródłowy projekt procesora, który można zintegrować z różnymi implementacjami SoC. Zidentyfikowanie systemu opartego na XiangShan wymaga zbadania platformy sprzętowej, a nie polegania na ogólnym identyfikatorze procesora. Zacznij od dokumentacji płytki, specyfikacji SoC lub oznaczeń układu, aby zidentyfikować bazową implementację. Jeśli system jest dostępny, sprawdź jego dzienniki rozruchu, drzewo urządzeń i opis sprzętu pod kątem informacji o procesorze, w tym ISA, liczby rdzeni, konfiguracji pamięci podręcznej i identyfikatorów specyficznych dla dostawcy. Zgłaszane rejestry CSR mvendorid, marchid i mimpid mogą również pomóc w identyfikacji implementacji, pod warunkiem że platforma udostępnia dla nich znaczące wartości.
Mapa pamięci umieszcza moduł debugowania i kontrolery pamięci podręcznej pod stałymi adresami, które identyfikują platformę.
| Gdzie występuje | Jak potwierdzić |
|---|---|
| Płytki Yanqihu i Nanhu | Dokumentacja platformy i stała mapa urządzeń peryferyjnych |
| Systemy badawcze | Artykuły projektowe i informacje o wydaniu |
| Obrazy oprogramowania | Drzewo urządzeń i adres bazowy modułu debugowania |
Rozpakowywanie i debugowanie
Moduł debugowania jest zgodny ze specyfikacją RISC-V External Debug Support 0.13.2 i znajduje się pod stałym adresem w przestrzeni peryferyjnej. OpenOCD domyślnie łączy się z nim przez połączenie remote bitbang.
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| Element | Wartość |
|---|---|
| ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Flagi kompilatora | -march=rv64gc -mabi=lp64d dla Yanqihu; -march=rv64gcbk -mabi=lp64d dla Nanhu, dodaj rozszerzenia, które włącza kompilacja |
| Moduł debugowania | 0x3802_0000 do 0x3802_0fff, protokół 0.13.2 |
| Bufor programu | 16 bajtów, używają go polecenia abstrakcyjne |
| Wyzwalacze | 10 wyzwalaczy kontroli dopasowania |
| misa (0x301) | ISA i włączone rozszerzenia |
| mvendorid (0xF11) | identyfikator dostawcy JEDEC, tylko do odczytu |
| marchid (0xF12) | identyfikator mikroarchitektury, tylko do odczytu |
| mimpid (0xF13) | wersja implementacji, tylko do odczytu |
| mhartid (0xF14) | hart wykonujący kod, tylko do odczytu |
Historia
Instytut Informatyki Chińskiej Akademii Nauk rozpoczął projekt XiangShan w 2019 roku, a prace nad pierwszą generacją rozpoczęły się w czerwcu 2020 roku. Peng Cheng Laboratory wykonało znaczną część projektu fizycznego, etapu, który przekształca logikę w układ, jaki fabryka może wyprodukować.
Zespół przedstawił swoje metody tworzenia na MICRO 2022, ważnej konferencji poświęconej architekturze komputerów. Beijing Institute of Open Source Chip, organizacja non-profit założona z partnerami branżowymi, koordynuje obecnie rozwój.
Gdzie jest używany
XiangShan dąży do wydajności komercyjnych procesorów aplikacyjnych, takich jak te stosowane w telefonach i serwerach. Naukowcy wykorzystują go do badania projektowania procesorów wysokiej klasy, a projekt publikuje swoje narzędzia do symulacji, weryfikacji i analizy wydajności wraz z rdzeniem.