XiangShan
Ecosistema RISC-VXiangShan es un núcleo RV64 de alto rendimiento y ejecución fuera de orden escrito en Chisel, iniciado en 2019 en el Instituto de Tecnología Informática de la Academia China de Ciencias. Sus generaciones llevan nombres de lagos, desde Yanqihu, fabricado en 2021, hasta Nanhu y Kunminghu.
Descripción general
| Especificación | Valor |
|---|---|
| Compatibilidad con ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Microarquitectura | Ejecución fuera de orden y emisión múltiple; las generaciones son Yanqihu, Nanhu y Kunminghu |
| Densidad de rendimiento | 5.3 CoreMark/MHz a 1.3 GHz (Yanqihu) |
| Huella de recursos | Orientado a ASIC; el proyecto no publica el recuento de LUT de FPGA |
| Dominio de reloj | 1.3 GHz en 28 nm (Yanqihu), 2 GHz en 14 nm (Nanhu, tape-out de 2023) |
XiangShan es un procesador RISC-V de código abierto y alto rendimiento que implementa la arquitectura de conjunto de instrucciones de 64 bits. Sus núcleos emplean ejecución fuera de orden, lo que permite procesar las instrucciones en un orden distinto al de su secuencia original en el programa. Este enfoque permite al procesador explotar el paralelismo a nivel de instrucción ejecutando operaciones independientes mientras otras instrucciones esperan a que se resuelvan sus dependencias. El hardware está descrito en Chisel, un lenguaje de construcción de hardware basado en Scala, y se distribuye bajo la Mulan Permissive Software License, Version 2.
El nombre es chino y significa Colinas Fragantes, un parque en el oeste de Pekín, y cada generación del diseño toma el nombre de un lago. La primera generación, Yanqihu, se tapeó en 2021 en un proceso de 28 nanómetros y funcionaba a 1,3 GHz, alcanzando 5,3 CoreMark/MHz. Taper out significa enviar un diseño terminado a una fábrica para su fabricación. Nanhu es la segunda generación, tapeada en 2023 en 14 nm a 2 GHz con RV64GCBK. Kunminghu, la tercera, está en desarrollo activo.
Microarquitectura

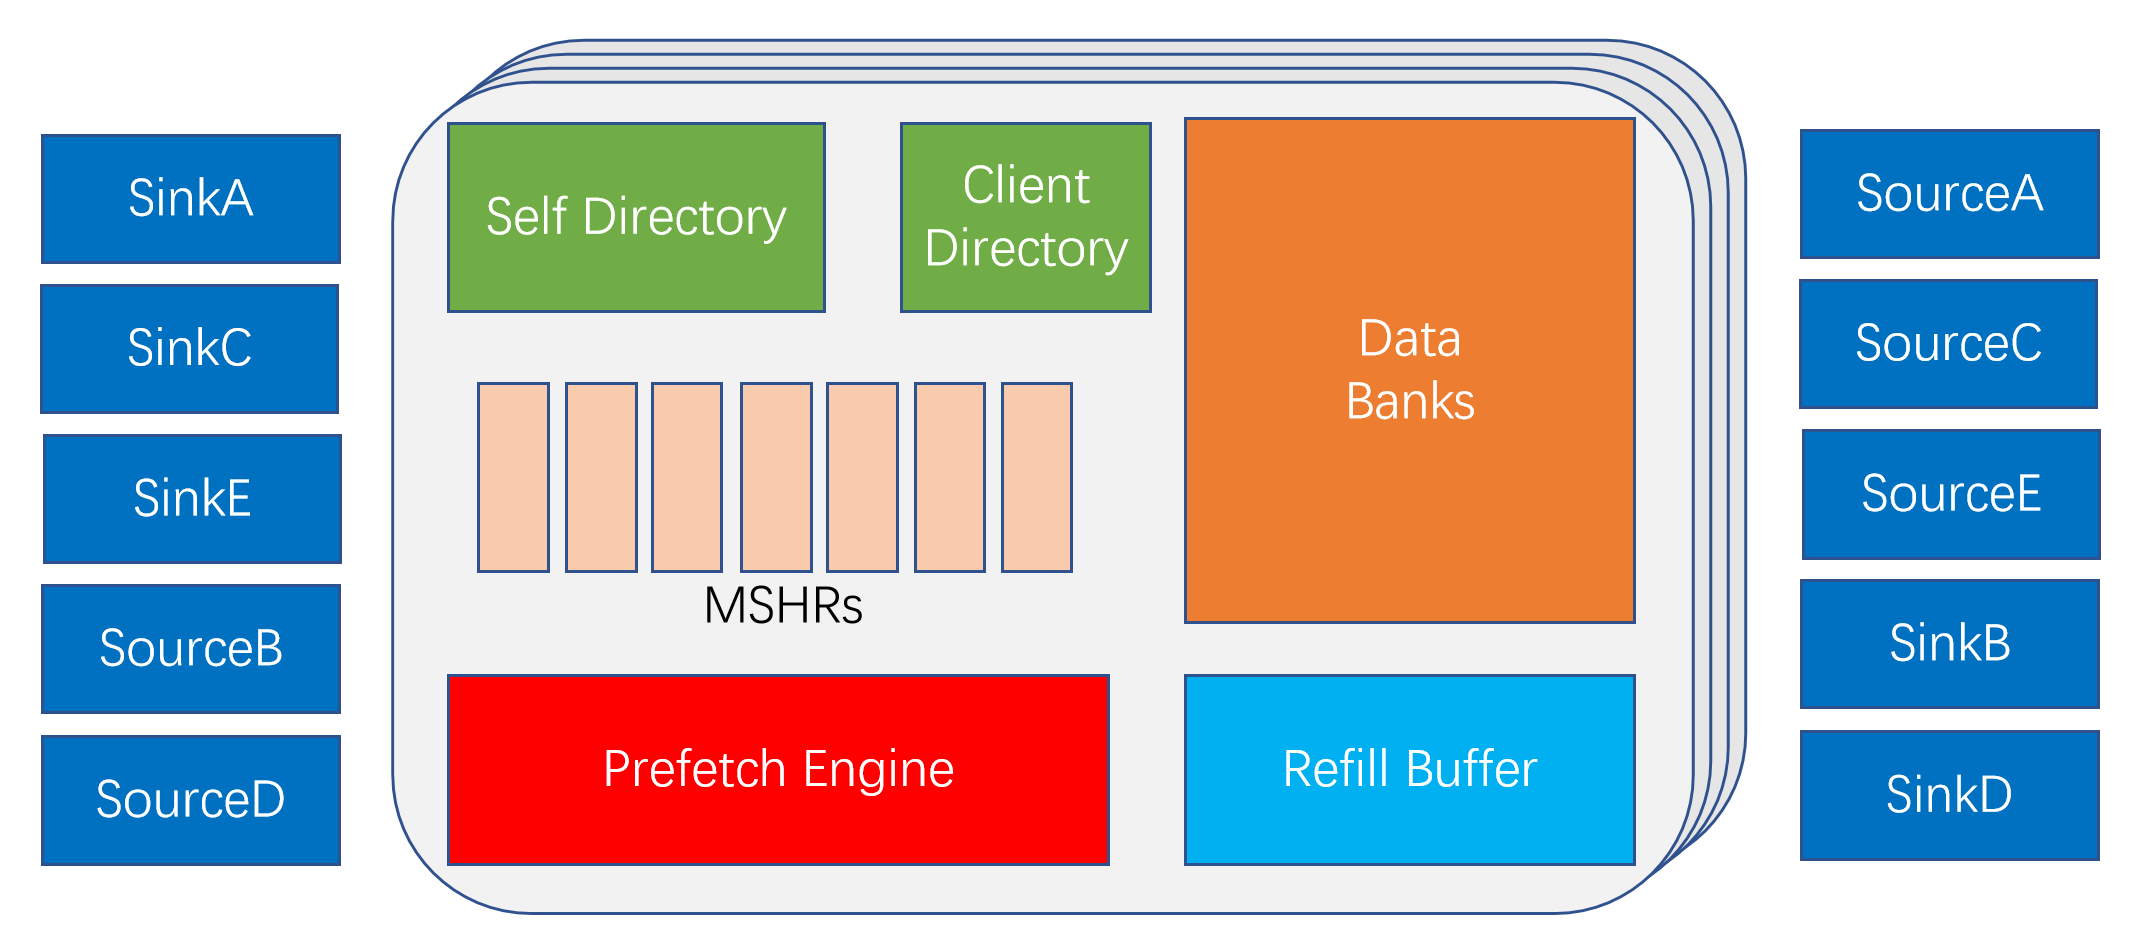
XiangShan emplea una arquitectura fuera de orden y de emisión múltiple, lo que permite despachar y ejecutar varias instrucciones de forma concurrente mientras se mantiene el orden de ejecución correcto visible para el programa. En la generación Nanhu, el subsistema de memoria incluye dos canalizaciones de carga, dos canalizaciones de dirección de almacenamiento y dos canalizaciones de datos de almacenamiento. Su caché de datos admite dos operaciones de lectura de 64 bits por ciclo, lo que proporciona ancho de banda adicional para cargas de trabajo con uso intensivo de memoria. Por encima de los núcleos individuales, Huancun proporciona una caché de último nivel compartida, lo que permite a varios núcleos acceder a una jerarquía de caché común.
Los accesos a memoria virtual se traducen a través de un Translation Lookaside Buffer (TLB), con un TLB L2 adicional que proporciona más capacidad de traducción. Los permisos y atributos de acceso a la memoria física se comprueban mediante los mecanismos Physical Memory Protection (PMP) y Physical Memory Attributes (PMA). La comunicación entre los núcleos del procesador y el sistema que los rodea se gestiona mediante el protocolo de interconexión TileLink.
| Parte | Yanqihu | Nanhu |
|---|---|---|
| ISA | RV64GC | RV64GCBK |
| Ejecución | Fuera de orden, multiemisión | Fuera de orden, multiemisión |
| Canalizaciones de carga | Dos | Dos |
| Canalizaciones de almacenamiento | Dos de dirección, dos de datos | Dos de dirección, dos de datos |
| Caché de datos L1 | Dos puertos de lectura de 64 bits, un puerto de escritura del ancho de línea | Dos puertos de lectura de 64 bits, un puerto de escritura del ancho de línea |
| Caché de último nivel | Huancun, compartida | Huancun, compartida |
| Interconnect | TileLink | TileLink |
Mapa de memoria y registros
El mapa de direcciones físicas predeterminado de XiangShan asigna rangos de direcciones específicos a los componentes del sistema, incluidos la memoria principal, los dispositivos periféricos y las regiones reservadas. La configuración de Physical Memory Attributes (PMA) define las propiedades de acceso permitidas para estas regiones, determinando qué tipos de operaciones pueden realizarse en cada rango de direcciones. Cuando el software intenta acceder a una dirección fuera de las regiones definidas o realiza una operación prohibida por los atributos correspondientes, el procesador genera un fallo de acceso. Este mecanismo permite al hardware hacer cumplir el diseño de memoria física de la plataforma y sus restricciones de acceso.
| Región | Rango de direcciones |
|---|---|
| Espacio periférico | 0x0000_0000 a 0x7fff_ffff |
| DDR | 0x8000_0000 a 0xf_ffff_ffff |
| CLINT | 0x3800_0000 a 0x3800_ffff |
| Unidad de error de bus | 0x3801_0000 a 0x3801_ffff |
| Módulo de depuración | 0x3802_0000 a 0x3802_0fff |
| Control de caché L3 | 0x3900_0000 a 0x3900_0fff |
| PLIC | 0x3c00_0000 a 0x3fff_ffff |
El Controlador de Interrupciones a Nivel de Plataforma (PLIC) recibe solicitudes de interrupción externas a través de las fuentes 1-64. Las fuentes 65 y 66 están reservadas para las interrupciones de error de bus generadas por el núcleo 0 y el núcleo 1, respectivamente.
Implementación física
XiangShan ha avanzado más allá del prototipado hacia la implementación física en silicio. Su diseño de primera generación, Yanqihu, completó el tape-out en 2021 utilizando un proceso de fabricación de 28 nm, con una frecuencia de funcionamiento reportada de 1,3 GHz y 5,3 CoreMark/MHz. La segunda generación, Nanhu, se tapeó en 2023 en un proceso de 14 nm a 2 GHz. Las generaciones posteriores han buscado nodos de proceso de semiconductores más avanzados y frecuencias de funcionamiento más altas, lo que refleja el desarrollo continuo del proyecto hacia implementaciones de procesador cada vez más capaces.
| Generación | Cifra reportada |
|---|---|
| Yanqihu | 28 nm, 1,3 GHz, 5,3 CoreMark/MHz, fabricado en 2021 |
| Nanhu | 14 nm, 2 GHz, fabricado en 2023 |
| Kunminghu | En desarrollo en el momento de escribir esto |
| FPGA | No se ha publicado el recuento de LUT para el núcleo |
Identificando la parte
XiangShan es un diseño de procesador de código abierto que puede integrarse en diferentes implementaciones de SoC. Identificar un sistema basado en XiangShan requiere examinar la plataforma de hardware en lugar de basarse en un identificador de procesador genérico. Comience por la documentación de la placa, las especificaciones del SoC o las marcas del chip para identificar la implementación subyacente. Si el sistema es accesible, inspeccione sus registros de arranque, el árbol de dispositivos y la descripción del hardware para obtener información del procesador, incluidos la ISA, el número de núcleos, la configuración de caché y los identificadores específicos del proveedor. Los CSR mvendorid, marchid y mimpid reportados también pueden ayudar a identificar la implementación, siempre que la plataforma exponga valores significativos para ellos.
El mapa de memoria sitúa el módulo de depuración y los controladores de caché en direcciones fijas, que identifican la plataforma.
| Dónde aparece | Cómo confirmar |
|---|---|
| Placas Yanqihu y Nanhu | Documentación de la plataforma y el mapa de periféricos fijo |
| Sistemas de investigación | Artículos del proyecto y notas de la versión |
| Imágenes de software | Árbol de dispositivos y la dirección base del módulo de depuración |
Desensamblaje y depuración
El módulo de depuración sigue la especificación RISC-V External Debug Support 0.13.2 y se sitúa en una dirección fija dentro del espacio de periféricos. OpenOCD se conecta a él mediante una conexión remote bitbang de forma predeterminada.
adapter driver remote_bitbang
remote_bitbang host localhost
remote_bitbang port 23334
jtag newtap $_CHIPNAME cpu -irlen 5| Elemento | Valor |
|---|---|
| ISA | Yanqihu: RV64GC, Nanhu: RV64GCBK |
| Indicadores del compilador | -march=rv64gc -mabi=lp64d para Yanqihu; -march=rv64gcbk -mabi=lp64d para Nanhu, añade las extensiones que habilita la compilación |
| Módulo de depuración | 0x3802_0000 a 0x3802_0fff, protocolo 0.13.2 |
| Búfer de programa | 16 bytes, los comandos abstractos lo usan |
| Disparadores | 10 disparadores de control de coincidencia |
| misa (0x301) | ISA y extensiones habilitadas |
| mvendorid (0xF11) | ID de proveedor JEDEC, solo lectura |
| marchid (0xF12) | ID de microarquitectura, solo lectura |
| mimpid (0xF13) | versión de implementación, solo lectura |
| mhartid (0xF14) | hart que ejecuta el código, solo lectura |
Historia
El Instituto de Computación de la Academia China de Ciencias puso en marcha XiangShan en 2019, y el trabajo en la primera generación comenzó en junio de 2020. El Peng Cheng Laboratory llevó a cabo gran parte del diseño físico, la etapa que convierte la lógica en un diseño que una fábrica puede producir.
El equipo presentó sus métodos de desarrollo en MICRO 2022, una importante conferencia de arquitectura de computadores. El Beijing Institute of Open Source Chip, una organización sin ánimo de lucro fundada con socios del sector, coordina ahora el desarrollo.
Dónde se usa
XiangShan aspira al rendimiento de los procesadores de aplicación comerciales, del tipo que se encuentra en teléfonos y servidores. Los investigadores lo utilizan para estudiar el diseño de procesadores de gama alta, y el proyecto publica sus herramientas de simulación, verificación y análisis de rendimiento junto con el núcleo.