
TeX
Data Structures 2
Академічний проект з Data Structures II. Порівнює ефективність п'яти алгоритмів сортування на C для різних розмірів вхідних даних, а потім генерує графіки продуктивності за допомогою Python/matplotlib.
Академічний проект для предмету Структури даних II. Проводить тестування п'яти алгоритмів сортування на C для різних розмірів вхідних даних, а потім генерує графіки продуктивності за допомогою Python/matplotlib.
Алгоритми
| Алгоритм | Середній випадок | Найгірший випадок |
|---|---|---|
| Bubble Sort | O(n²) | O(n²) |
| Selection Sort | O(n²) | O(n²) |
| Insertion Sort | O(n²) | O(n²) |
| Quick Sort | O(n log n) | O(n²) |
| Heap Sort | O(n log n) | O(n log n) |
Як це працює
- C-програма (
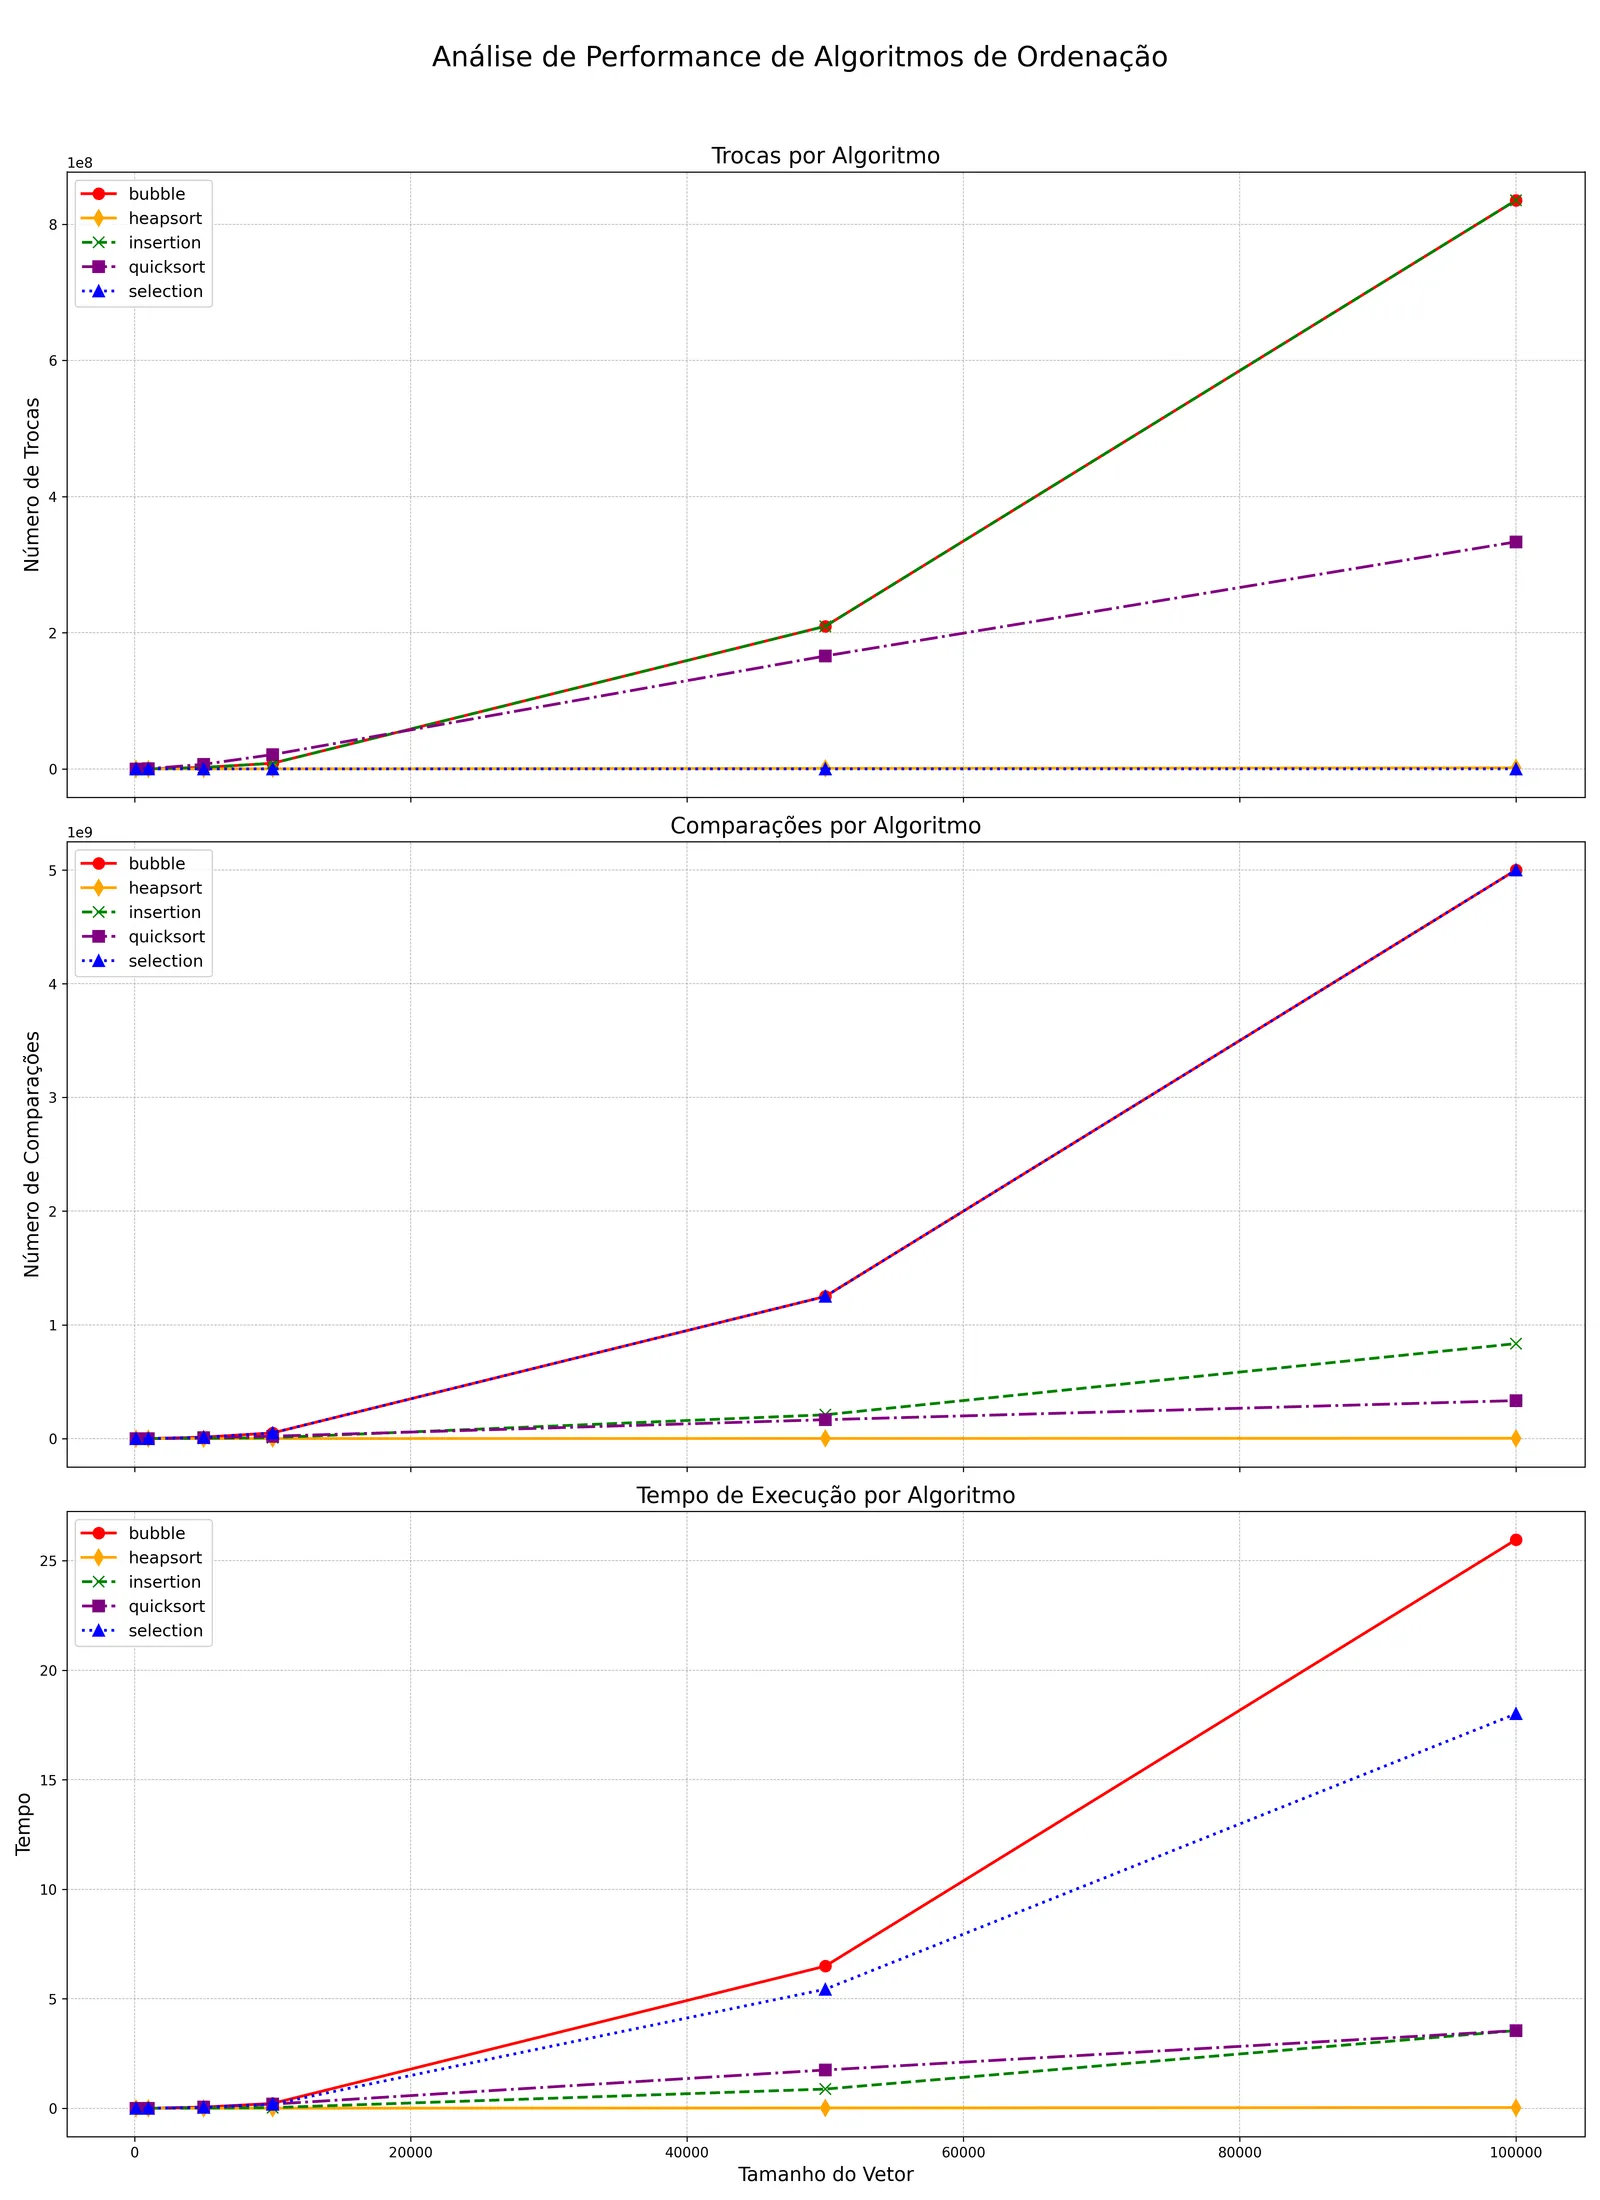
main.c+sorting.c) генерує випадкові масиви цілих чисел розміром[100, 1000, 5000, 10000, 50000, 100000], запускає кожен алгоритм на копії, і записує метрики за кожним запуском (обміни, порівняння, затрачений час) у двійкові файли у каталозі./executions/. - Python-скрипт (
main.py) компілює та запускає C-програму, читає двійкові дані і зберігає графіки продуктивності у./graficos/.
Вимоги
- GCC
- Python 3
- matplotlib (
pip install matplotlib)
Використання
# Запустити тестування + генерувати графіки
python main.py
Або запустити лише C-тестування:
make
./Trabalho_Pratico_II
Вихід
Графіки збережені у ./graficos/:
relatorio_completo.png— обміни, порівняння та час у одній діаграміtrocas_comparacao.png— обміни за алгоритмомcomparacoes_comparacao.png— порівняння за алгоритмомtempo_comparacao.png— час виконання за алгоритмом
Структура проекту
.
├── main.c          # Benchmark driver
├── sorting.c       # Algorithm implementations
├── sorting.h       # Function declarations
├── main.py         # Data reader + chart generator
├── makefile
├── requirements.txt
└── executions/     # Binary result files (generated at runtime)