
Моделювання суперника для навчання моделей на основі пошуку по дереву Монте-Карло в настільній грі Citadels
Andrei Carlesso Camilotto, Felipe Grando, João Luis Almeida Santos, Eduardo V. P. Fiorentin, Djonatan R. C. Bonelli
Анотація
У цій роботі досліджується, як моделювання супротивника впливає на навчання гібридної структури MCTS-RL, застосованої до багатокористувацької настільної гри Citadels, яка містить приховану інформацію, кількох гравців та часові обмеження. Пропозиція розділяє планування та виконання через постійну структуру прийняття рішень, побудовану офлайн із симуляцій, що зменшує онлайн-обчислювальні витрати MCTS. У середовищі симуляції з експертними агентами та випадковим агентом різні сесії навчання (включно з різноманітним середовищем) порівнюються за відсотком перемог. Результати вказують на те, що різноманітність стратегій під час навчання, як правило, дає стійкішого та універсальнішого агента, ніж навчання проти окремо сильних супротивників.
1. Вступ
Monte Carlo Tree Search (MCTS) зарекомендував себе як ефективну техніку прийняття рішень у настільних іграх, поєднуючи адаптивність і низьке використання знань, специфічних для предметної області. Його продуктивність є помітною в детермінованих іграх з повною інформацією, таких як Go (SILVER et al., 2016).
Однак його застосування стикається зі значними обмеженнями в середовищах з кількома гравцями, прихованою інформацією та часовими обмеженнями, де висока обчислювальна вартість симуляцій і складність адаптації ставлять під загрозу швидкість реагування та якість рішень (POWLEY et al., 2014).
У цьому контексті гібридні підходи, що інтегрують MCTS і навчання з підкріпленням (RL), продемонстрували перспективність, дозволяючи відокремити фазу планування від виконання. Побудова постійних структур прийняття рішень із попереднім збереженням результатів пошуку уможливлює миттєвий вибір дій під час гри, зменшуючи потребу в онлайн-симуляціях і зберігаючи стратегічну глибину (BROWNE, 2012; SWIECHOWSKI, 2023).
У цьому дослідженні було протестовано та розроблено гібридну модель MCTS з методами офлайн-навчання з підкріпленням. Модель навчалася та тестувалася з використанням різних супротивників у середовищі симуляції настільної гри Citadels (FAIDUTTI, 2016).
2. Загальна мета
Загальна мета цього дослідження — розробити гібридну структуру MCTS-RL, здатну ефективно функціонувати в багатокористувацьких настільних іграх із прихованою інформацією, використовуючи Citadels як приклад.
Пропозиція прагне усунути обчислювальні вузькі місця традиційного MCTS шляхом офлайн-побудови постійної структури прийняття рішень, що дозволяє швидкі та надійні дії під час виконання.
3. Методологія
Це дослідження характеризується як прикладне експериментальне дослідження з якісно-кількісним аналізом.
Перший етап включав розробку та адаптацію середовища цифрової симуляції для настільної гри Citadels. Далі було розроблено п'ять експертних агентів із налаштованими стратегіями, створених для імітації реальних стратегій, які використовують гравці-люди, а також розроблено базового агента, який обирає дії випадково. Після валідації середовища та розроблених агентів розпочалася розробка гібридної структури MCTS-RL.
Модель MCTS за своєю суттю є евристичним алгоритмом пошуку, який працює шляхом виконання численних симуляцій. Для кожного окремого стану гри, відвіданого під час цих симуляцій, у деревоподібній структурі даних створюється відповідний вузол. Початковий стан гри представляє кореневий вузол цього дерева.
Однак пропозиція зберігати все дерево та зберігати його для майбутніх рішень є нездійсненною через величезний коефіцієнт розгалуження. Щоб зробити це можливим, необхідно абстрагувати дерево: стан гри поділяється на його фундаментальні характеристики (наприклад, золото гравця, кількість карт у руці), і кожна характеристика відображається на незалежну таблицю даних.
У цій структурі рядки таблиці представляють можливі значення характеристики стану, а стовпці представляють можливі дії, які може виконати агент (наприклад, отримати золото, взяти карти). У кожній клітинці зберігаються два значення: кількість досягнутих перемог (n) після виконання цієї дії в цьому стані та загальна кількість разів, коли ця комбінація була досліджена (m). Ці таблиці, наповнені через симуляції матчів Citadels, конфігурують навчену модель агента.
Процес навчання включає компонент навчання з підкріпленням: після кожного симульованого матчу результати оновлюють таблиці рішень, впливаючи на майбутні вибори. Перемоги діють як винагороди та підкріплюють ефективні дії, збільшуючи ймовірність їх повторного вибору, тоді як поразки зменшують цю можливість. Таким чином, протягом багатьох симуляцій модель безперервно адаптується, балансуючи між дослідженням нових альтернатив і використанням перевірених стратегій, поступово сходячись до ефективніших моделей поведінки.
4. Результати та обговорення
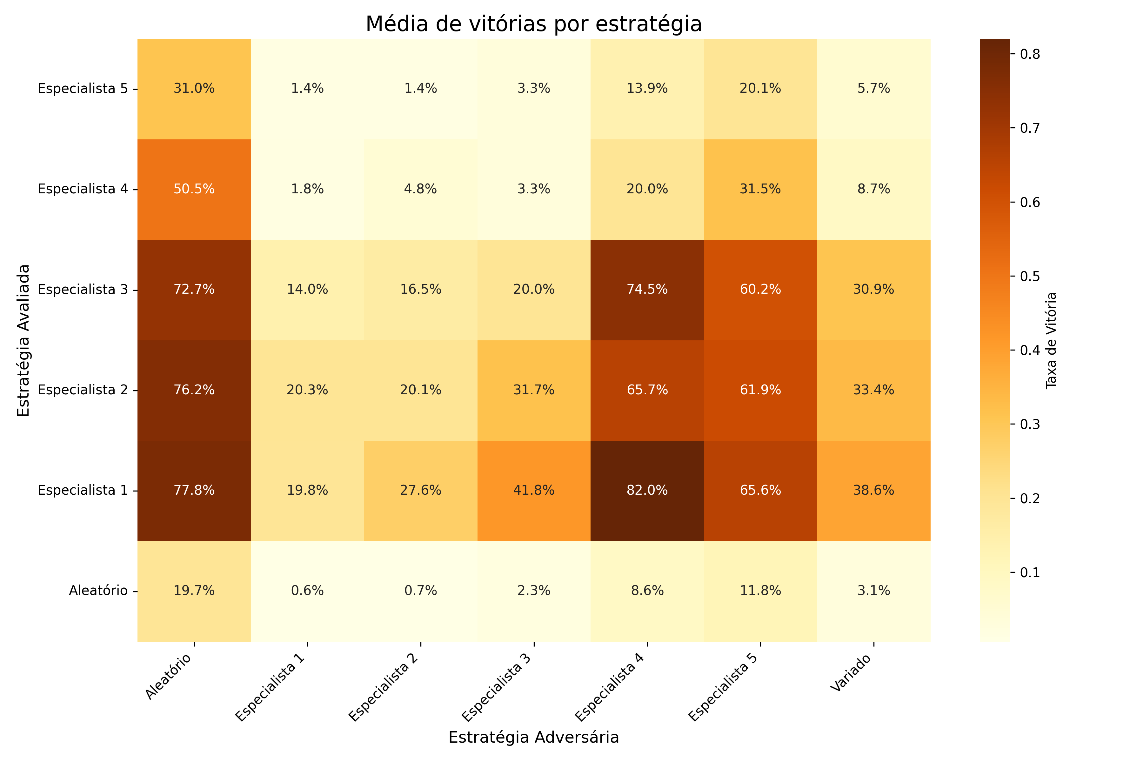
Щоб оцінити продуктивність запропонованої моделі MCTS, було важливо зрозуміти динаміку сил між базовими стратегіями (експертними агентами та випадковим агентом). Для цього кожен із них був підданий раунду з 10 000 матчів проти чотирьох ідентичних супротивників.
Теплова карта, представлена на рисунку 1, ілюструє продуктивність кожної стратегії (вісь Y) проти різних супротивників (вісь X). Стратегії мають різні сильні та слабкі сторони: експерти 1, 2 і 3 виявляються компетентними в більшості сценаріїв, тоді як експерти 4 і 5 є значно менш ефективними. Як і очікувалося, повністю випадкова стратегія демонструє дуже низьку продуктивність проти будь-якого мінімально структурованого супротивника.
Наступним кроком було оцінювання моделі MCTS-RL. Було проведено різні сеанси тренування, кожен з яких зосереджувався на одному з супротивників, загалом 100 000 тренувальних матчів для кожної версії моделі. Потім продуктивність кожної натренованої моделі вимірювалася проти всіх типів супротивників за тією ж попередньою моделлю тестування, а також проти випадково вибраних різноманітних супротивників.
Теплова карта, показана на рисунку 2, відображає зведений відсоток перемог кожної моделі. Найзначнішим був результат моделі, натренованої в різноманітному середовищі, яка досягла стабільної продуктивності, перевершуючи інші версії моделі майже в усіх тестових сценаріях. Це свідчить про те, що вплив різноманітності стратегій під час тренування був визначальним для розвитку більш надійної та універсальної ігрової здатності.
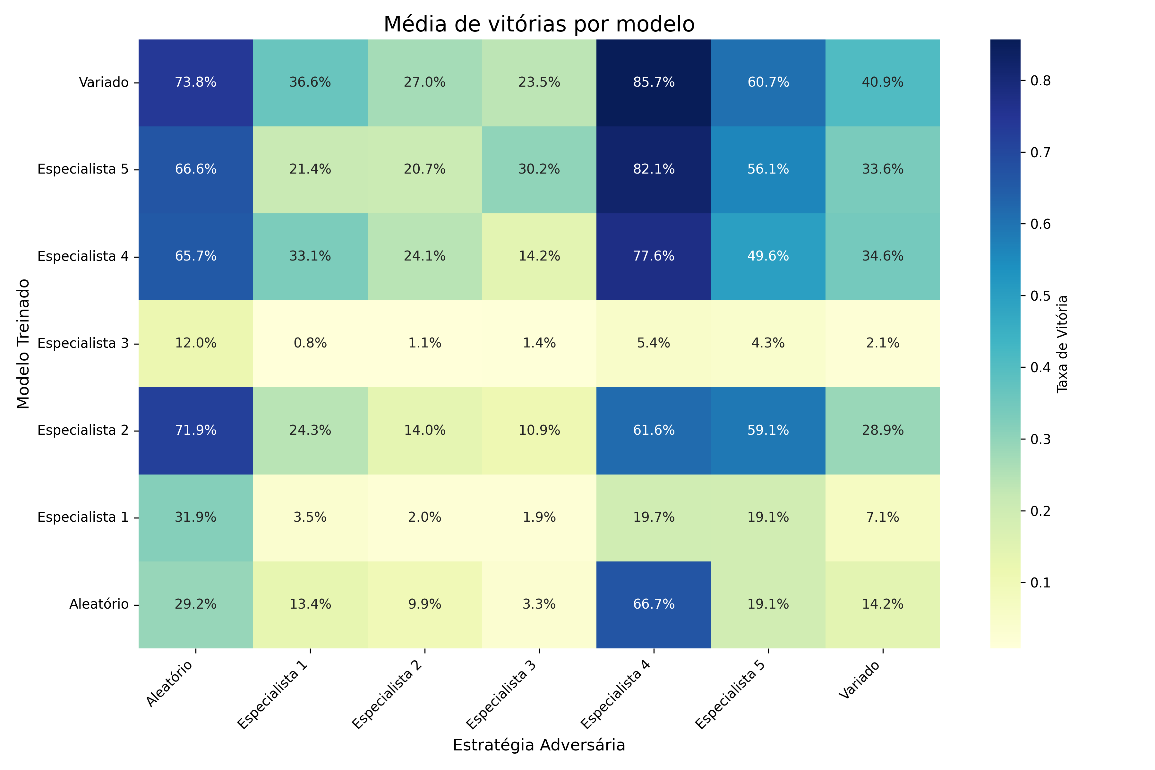
Моделі, натреновані проти Експертів 4 і 5, яких вважають найслабшими супротивниками, стали напрочуд ефективними агентами. Натомість тренування проти Експертів 1 і 3, яких вважають сильними супротивниками, дало моделі з дуже поганою загальною продуктивністю.
Можливе пояснення цього контрасту полягає в тому, що просунуті експертні стратегії, як правило, є вузькоспеціалізованими, тоді як модель MCTS-RL на початку тренування наближається до випадкової поведінки. Проти сильних супротивників навіть потенційно вигідні дії можуть не призвести до достатньої кількості перемог, щоб модель розпізнала закономірності успіху; тоді як проти менш спеціалізованих супротивників перемоги трапляються частіше, що сприяє навчанню. Утім, це залишається гіпотезою, яка потребує підтвердження.
5. Висновок
Це дослідження продемонструвало життєздатність запропонованого підходу, який використовує абстракцію дерева MCTS для збереження набутих знань між ходами. Результати підтвердили, що модель здатна розробляти надійні стратегії для середовища.
Вища продуктивність агента, натренованого в різноманітному середовищі, показує, що вплив багатьох тактик є визначальним для побудови універсальної моделі. Крім того, дослідження вказує на те, що якість кінцевого агента залежить більше від різноманітності, ніж від очевидної сили супротивників під час тренування.
Як майбутні дослідження було б цікаво точніше дослідити фактичні причини того, чому менш спеціалізовані стратегії дали ефективніші моделі, ніж сильніші стратегії. Крім того, порівняння запропонованої моделі з іншими моделями MCTS також допомогло б отримати точнішу оцінку підходу.
Посилання
- [1]Browne, C. B. et al. (2012). A survey of Monte Carlo Tree Search methods. IEEE Transactions on Computational Intelligence and AI in Games, 4(1), 1–43.
- [2]Faidutti, B. (2016). Citadels. Deluxe ed. Roseville, MN, USA. Rulebook.
- [3]Powley, E. J.; Cowling, P. I.; Whitehouse, D. (2014). Information capture and reuse strategies in Monte Carlo tree search, with applications to games of hidden information. Artificial Intelligence, 217, 92–116.
- [4]Silver, D. et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature, 529(7587), 484–489.
- [5]Swiechowski, M. et al. (2023). Monte Carlo tree search: a review of recent modifications and applications. Artificial Intelligence Review, 56(3), 2497–2562.